2026년 9월 28일 월요일

mRNA 백신은 왜 차갑게 보관할까? AI가 찾은 더위에 강한 제형

한 문장 답: AI가 백신을 새로 발명한 것이 아니라, mRNA를 담은 작은 지질 입자가 건조·보관을 견디도록 보존제 조합을 찾아낸 연구입니다. 아직 사람에게 쓰는 상온 백신이 완성됐다는 뜻은 아닙니다.

실험 단계: 세포와 동물의 전임상 연구. 인간 임상시험이나 감염 예방률을 측정한 연구가 아닙니다. 접종·보관 지침을 바꾸거나 직접 제형을 만드는 안내도 아닙니다.

설계도와 포장을 함께 지켜야 합니다

mRNA는 세포가 단백질을 만드는 데 읽는 정보입니다. 지질 나노입자(LNP)는 이를 보호하고 세포에 전달하는 포장입니다. 비유하면 택배 안의 설계도와 상자에 가깝습니다. 설계도만 온전해도 상자가 제대로 전달하지 못하면 충분한 단백질이 만들어지지 않습니다. 실제 입자는 단순한 빈 상자보다 훨씬 복잡합니다.

물을 빼면 어떤 분해 과정은 줄일 수 있지만, 말리고 다시 풀 때 입자가 뭉치거나 상태가 변할 수 있습니다. 그래서 연구진은 “잘 말랐는가”보다 다시 물에 풀어 세포에 넣었을 때 기능이 남았는가를 확인했습니다.

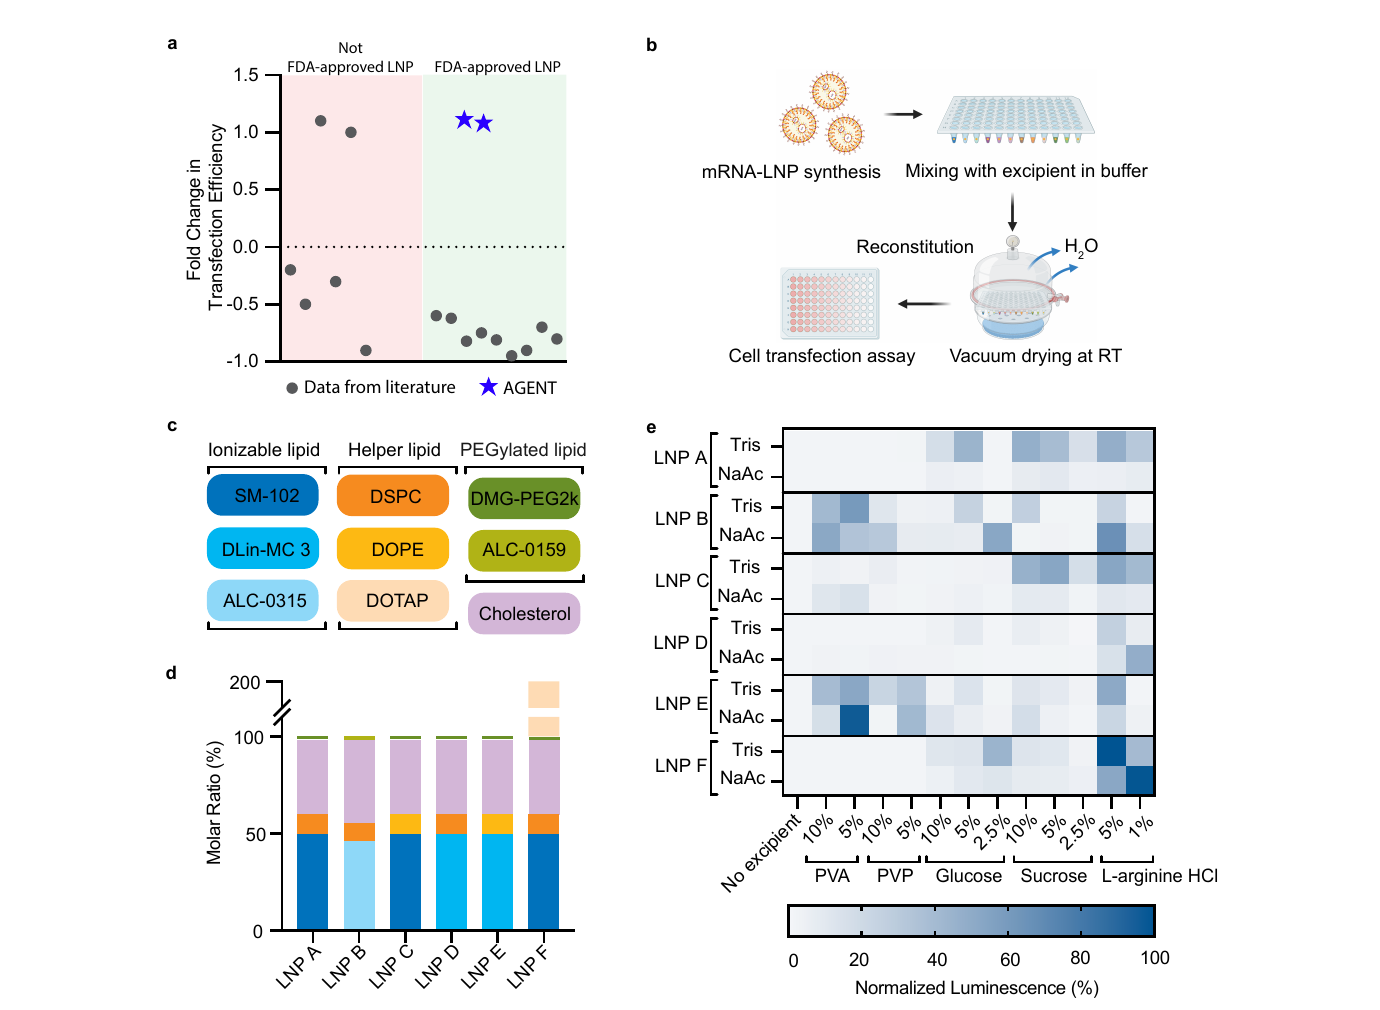
진공건조와 재용해 과정, 보존제 조합별 세포 발광의 원본 Figure 1
원본 Figure 1: 먼저 b의 공정 화살표, 그다음 e의 바둑판을 봅니다. 칸의 색은 세포 발광의 상대값이지 예방률이 아닙니다. Jinbi Tian, Khanh T. M. Tran et al., bioRxiv v1, CC BY 4.0. 그림 영역 렌더링, 패널·측정값 수정 없음.

AI는 무엇을 바꿨을까요?

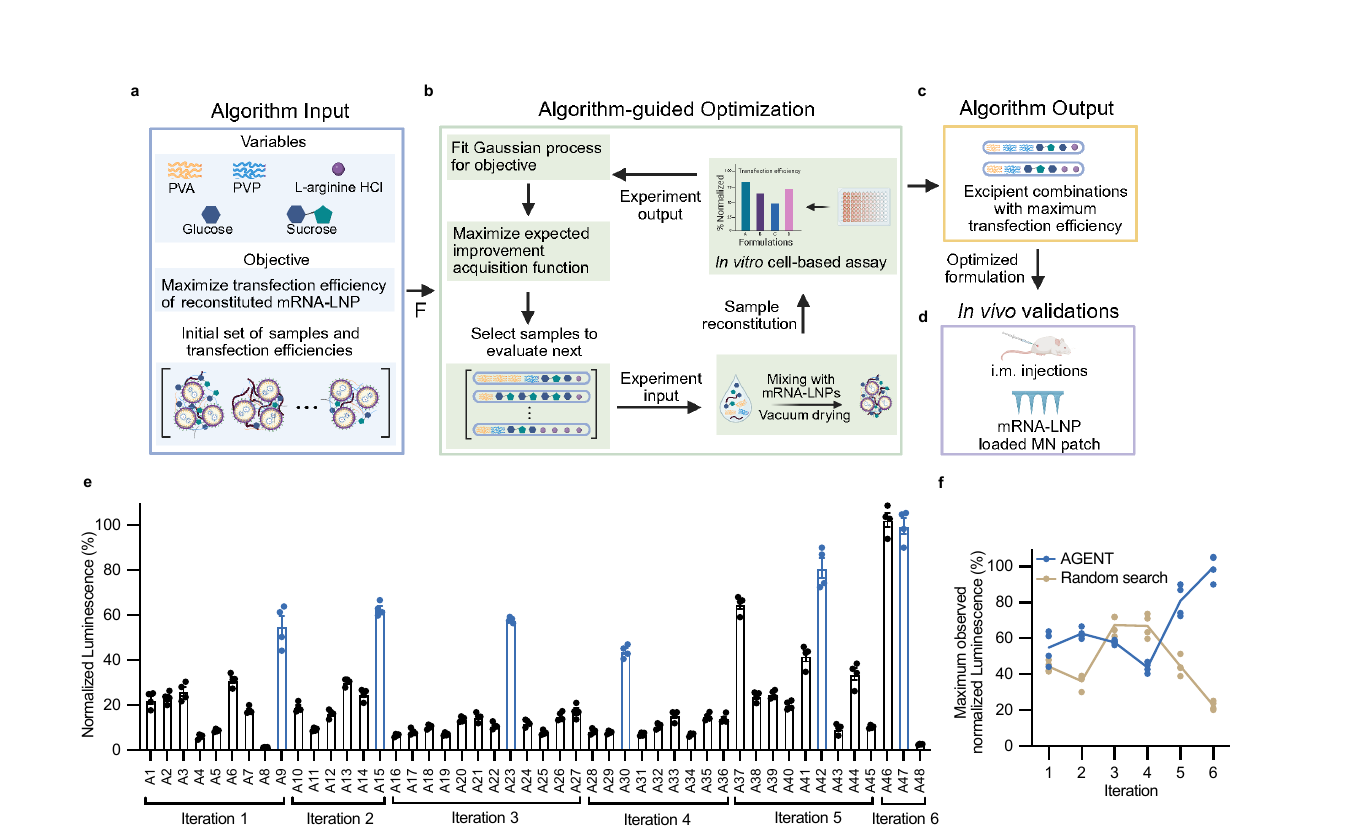
9월 28일 Nature Biotechnology에 발표된 AGENT는 실제 시험 결과를 받아 다음 조합을 추천합니다. 이번 결과는 9월 29일 연구 뉴스로 소개합니다. 조합을 만들고 말리고 시험한 뒤, 결과를 다시 모델에 넣습니다. 이전에 잘 나온 곳뿐 아니라 아직 잘 모르지만 좋아질 가능성이 있는 곳도 고릅니다.

연구자는 재료와 탐색 범위를 먼저 정합니다. 알고리즘이 안전 규칙까지 스스로 정하거나 실험을 생략한 것은 아닙니다. 공개 원고의 LNP A 탐색에는 여섯 차례 반복과 48개 조합이 쓰였습니다. 여섯 번의 반복이 시료 여섯 개를 뜻하지는 않습니다.

실험 결과로 모델을 갱신하고 다음 제형을 고르는 AGENT 원본 Figure 2
원본 Figure 2: 가운데 b의 원을 따라 읽으면 추천→제조→측정→갱신입니다. f는 같은 표본 수의 탐색 비교이며 모든 문제에서 AI가 이긴다는 증거는 아닙니다. Tian, Tran et al., bioRxiv v1, CC BY 4.0. 전체 패널·축 유지.

100%라는 숫자는 분모를 봐야 합니다

발광 유지 비율
건조 뒤 발광 ÷ 대응 용액의 발광 × 100

가상 예로 용액의 발광이 1,000, 말린 뒤 발광이 950이면 비율은 95%입니다. 이는 같은 시험에서 남은 상대 기능이지 100명 중 95명의 감염을 막았다는 뜻이 아닙니다. 논문의 “활성 유지 100%”도 사람의 예방률과 구분해야 합니다.

실제 패치 사진은 무엇을 보여 줄까요?

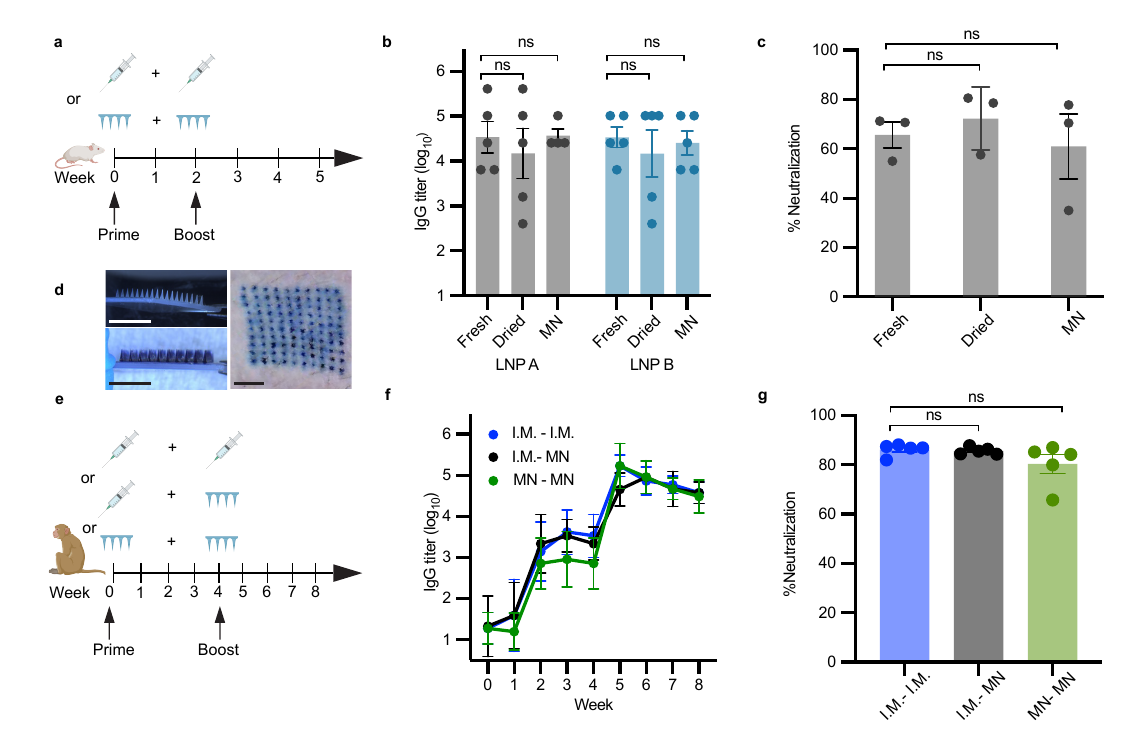
실제 미세바늘 패치와 비인간 영장류 피부 염색 사진 및 동물 항체 그래프
원본 Figure 5: d는 실제 패치와 동물 피부의 염색 사진입니다. a–c는 쥐, e–g는 영장류 시험입니다. 사람 접종 사진이 아닙니다. Tian, Tran et al., bioRxiv v1, CC BY 4.0. 사진·점·축 변경 없음.

연구진은 더운 조건에서 보관한 제형의 기능과 동물 면역반응을 확인했습니다. 그러나 실온 일 년 결과는 별도의 발광 표지 mRNA 시험입니다. 같은 백신이 사람에게 일 년 동안 예방 효과를 유지했다는 뜻은 아닙니다. 항체 반응과 실제 감염 예방도 서로 다른 측정입니다.

사람에게 쓸 제품이 되려면 제조 배치, 습도와 포장, 장기 안전성, 임상 효과를 더 검증해야 합니다. 그래프의 ns도 “통계적으로 차이를 찾지 못함”이지 완전히 같은 효과를 증명했다는 표시는 아닙니다.

공식 자료와 더 깊은 해설

정식 논문 · 도판 출처인 공개 원고 v1. 공개 원고 그림의 라이선스와 동료평가 출판본의 상태를 구분해 사용했습니다. 일부 저자의 기업 관련 이해관계는 논문에 공개돼 있습니다.

GitBlog 전체 해설에서는 GP·기대 개선량 수식의 기호와 단위, 기존 탐색법과의 차이, 원본 그림의 각 패널을 이어서 설명합니다.

라벨: , , , ,

2026년 9월 22일 화요일

HER2 양성 담도암 4제 병용, 55% 반응률 읽는 법

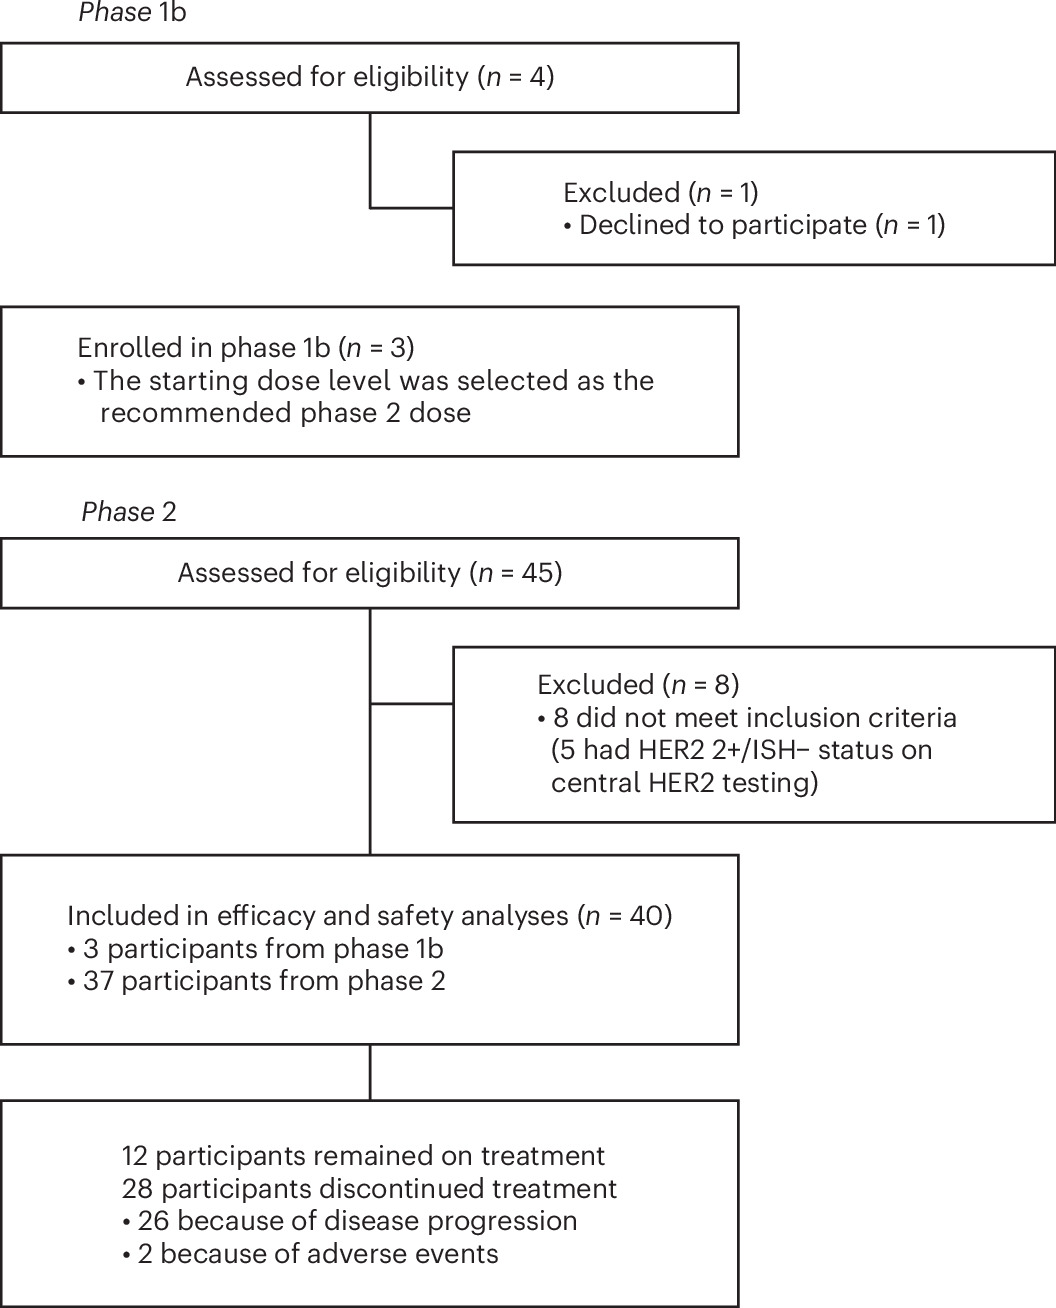
원문 Figure 1. HERBOT 1b상과 2상 참가자 흐름

원문 Figure 1. 사람 임상 1b/2상, 단일군 40명입니다. 대규모 무작위 3상이나 동물실험이 아닙니다.

한 문장으로 답하면, HER2 양성 진행성 담도암의 첫 치료부터 trastuzumab·nivolumab·gemcitabine·cisplatin을 함께 쓴 40명 연구에서 55%가 객관적 반응을 보였습니다. 공식 논문의 면역항암제는 durvalumab이 아니라 nivolumab입니다.

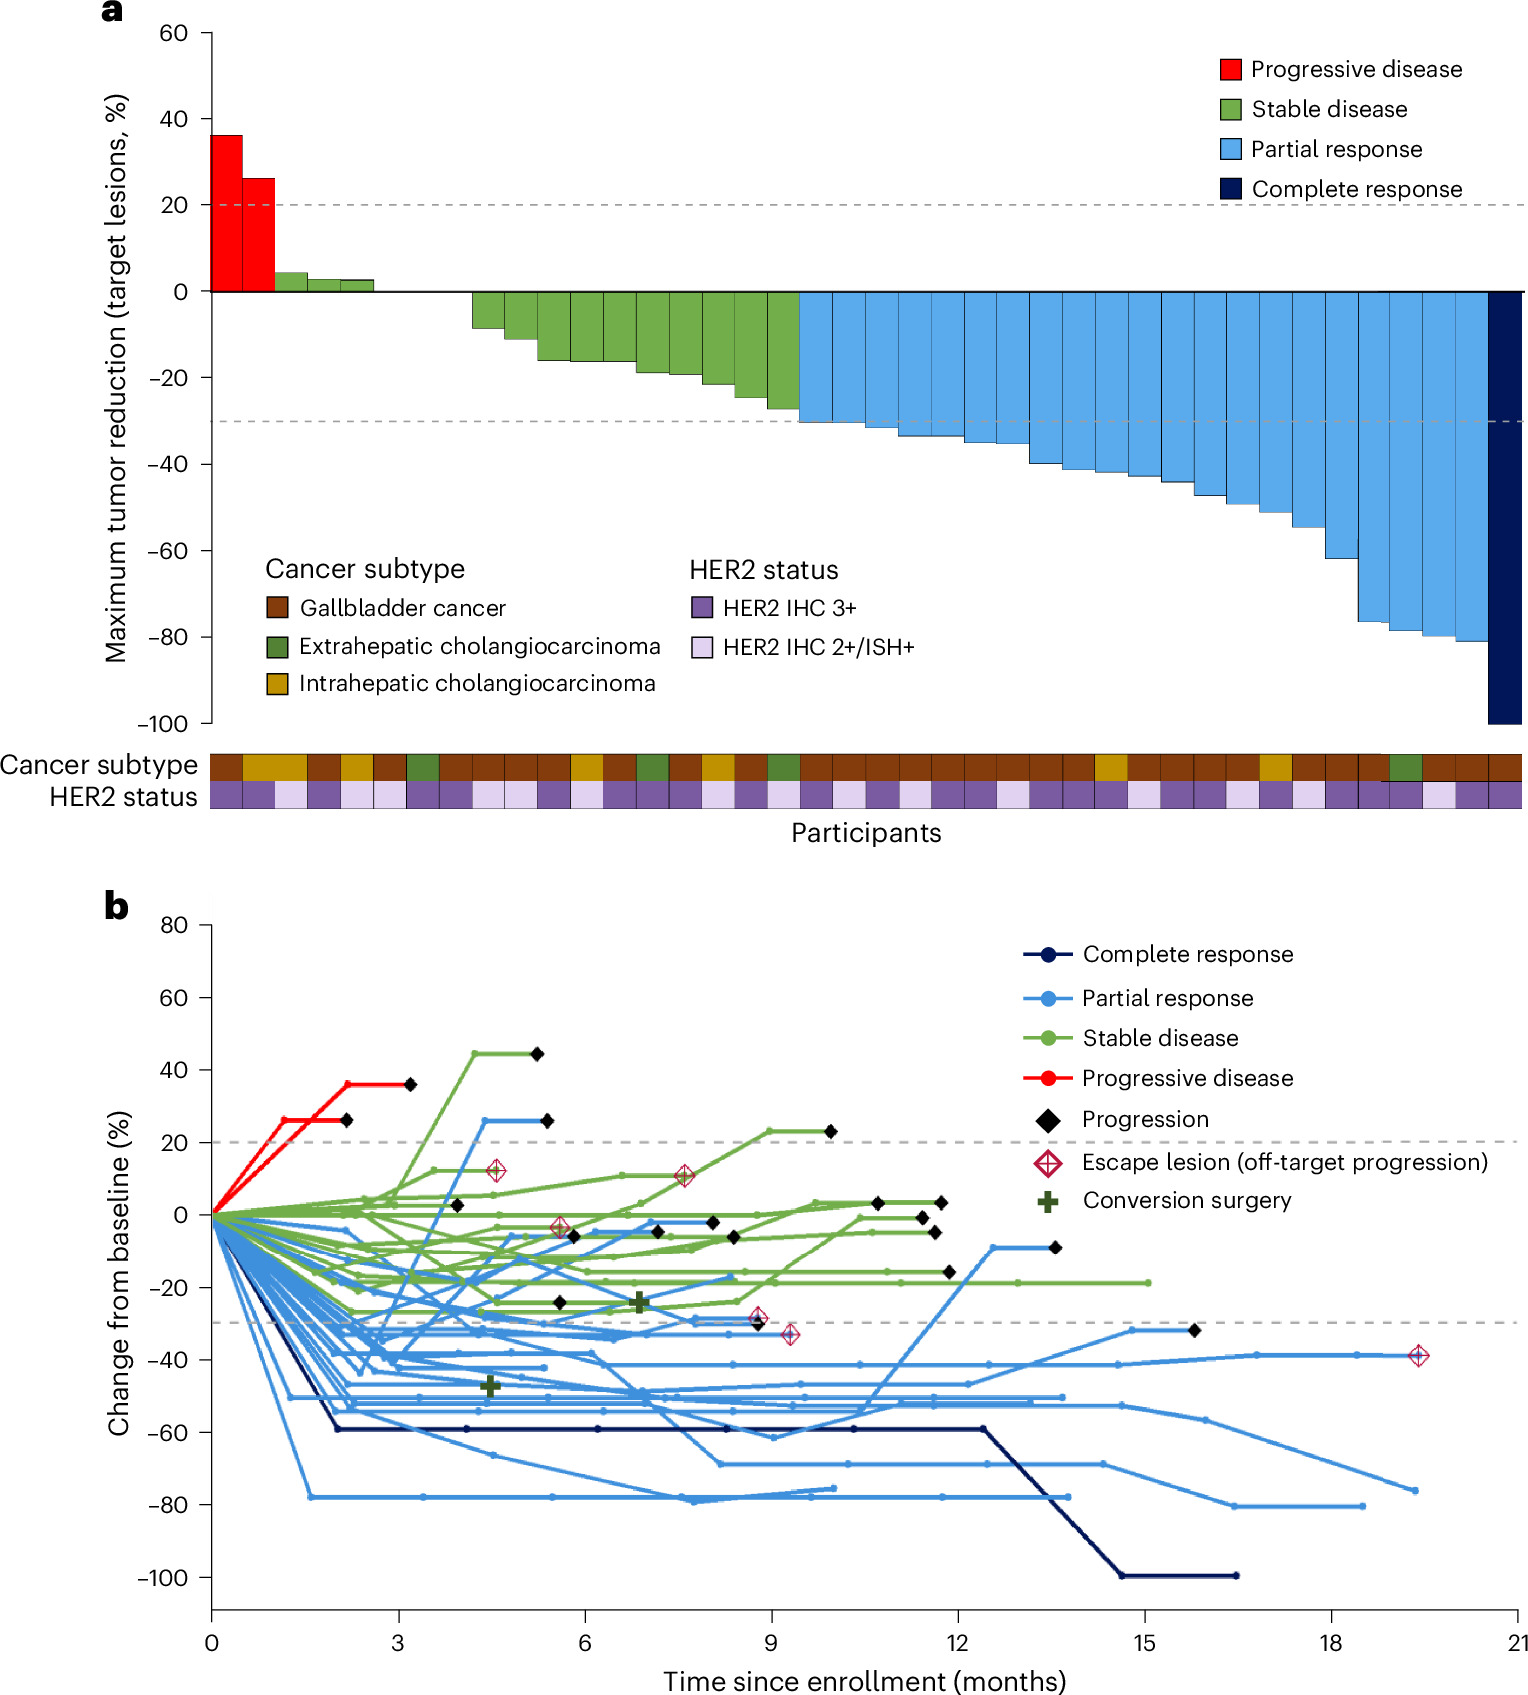
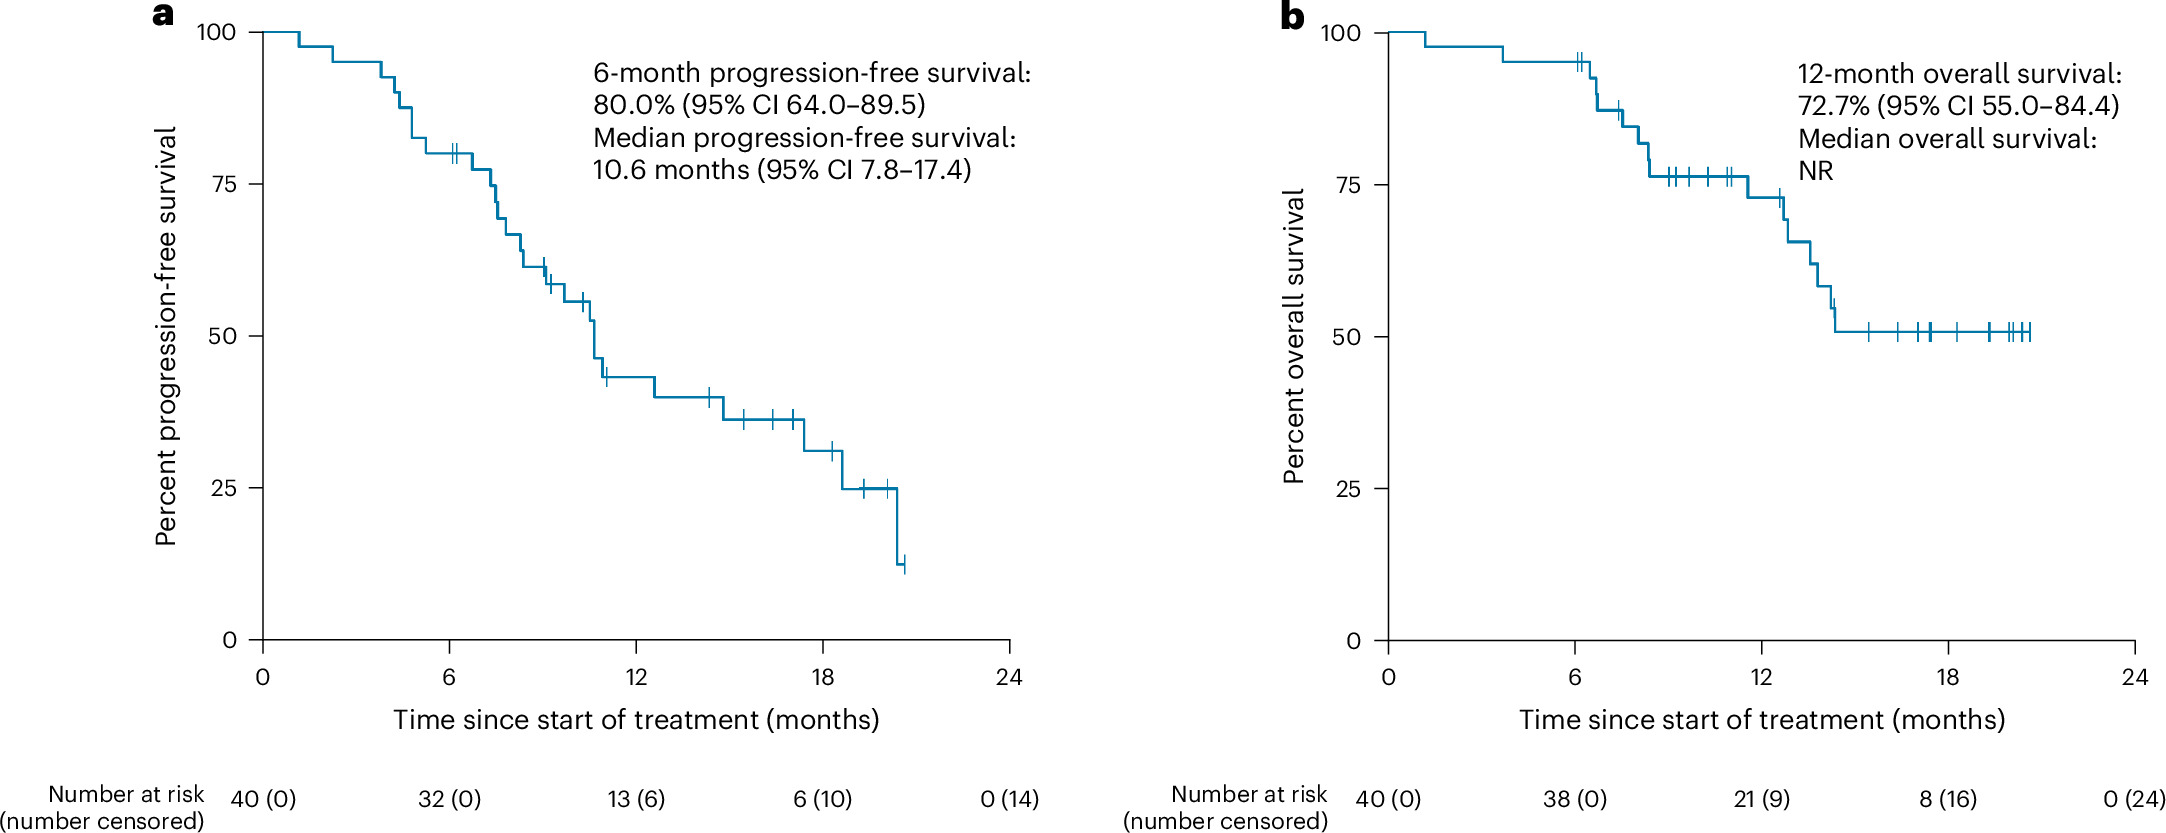
55%는 기존 치료보다 55% 좋아졌다는 뜻이 아닙니다. complete response 1명과 partial response 21명, 합계 22명을 전체 40명으로 나눈 값입니다. 95% 신뢰구간은 38.5~70.7%로 넓습니다. stable disease까지 합친 DCR은 95%, median PFS는 10.6개월이었습니다.

ORR = (CR + PR) ÷ 전체 = (1 + 21) ÷ 40 = 55%

55%는 이 단일군에서 종양이 RECIST 기준으로 줄어든 비율입니다. 비교군이 없어 치료 추가분만 분리할 수는 없습니다.

원문 Figure 2. 환자별 종양 감소 waterfall plot과 시간 변화

원문 Figure 2. 막대 하나가 환자 한 명입니다. -30% 아래는 partial response 크기 기준과 연결되고, 아래 시간 그래프는 감소가 얼마나 이어졌는지 보여 줍니다.

결과와 함께 부작용도 봐야 합니다. grade 3 이상 neutropenia 57.5%, anemia 30.0%, thrombocytopenia 22.5%가 보고됐습니다. 1b상 3명에서 dose-limiting toxicity가 없었다는 사실이 모든 환자에게 가벼운 치료라는 뜻은 아닙니다.

원문 Figure 3. 40명의 PFS와 OS Kaplan-Meier 곡선

원문 Figure 3. 계단은 진행 또는 사망 사건에서 내려갑니다. 십자가는 그 시점까지 관찰됐지만 이후를 모르는 censoring이며, 완치를 뜻하지 않습니다.

가장 큰 한계는 무작위 대조군이 없다는 점입니다. 참가자는 HER2 양성으로 선별됐고 72.5%가 담낭암이었습니다. 다른 임상시험의 반응률을 바로 빼서 치료 효과라고 할 수 없습니다. AI 병리 분석에서 HER2 3+ 세포 비율이 높은 집단의 반응이 더 좋아 보였지만, 15명 대 25명의 exploratory subgroup이라 독립 검증이 필요합니다.

다음 확인점은 randomized phase 3입니다. 같은 HER2 기준의 환자를 기존 chemoimmunotherapy와 4제 병용에 배정해 PFS·OS·삶의 질과 독성을 비교해야 합니다. 이 결과는 고무적인 2상 신호이지 개인 치료 지침이 아닙니다.

공식 자료

이 글은 논문 해설이며 개인의 진단·치료 결정을 대신하지 않습니다.

라벨: , , ,

9만 6천 개 자석 스핀이 배선 문제를 푸는 원리

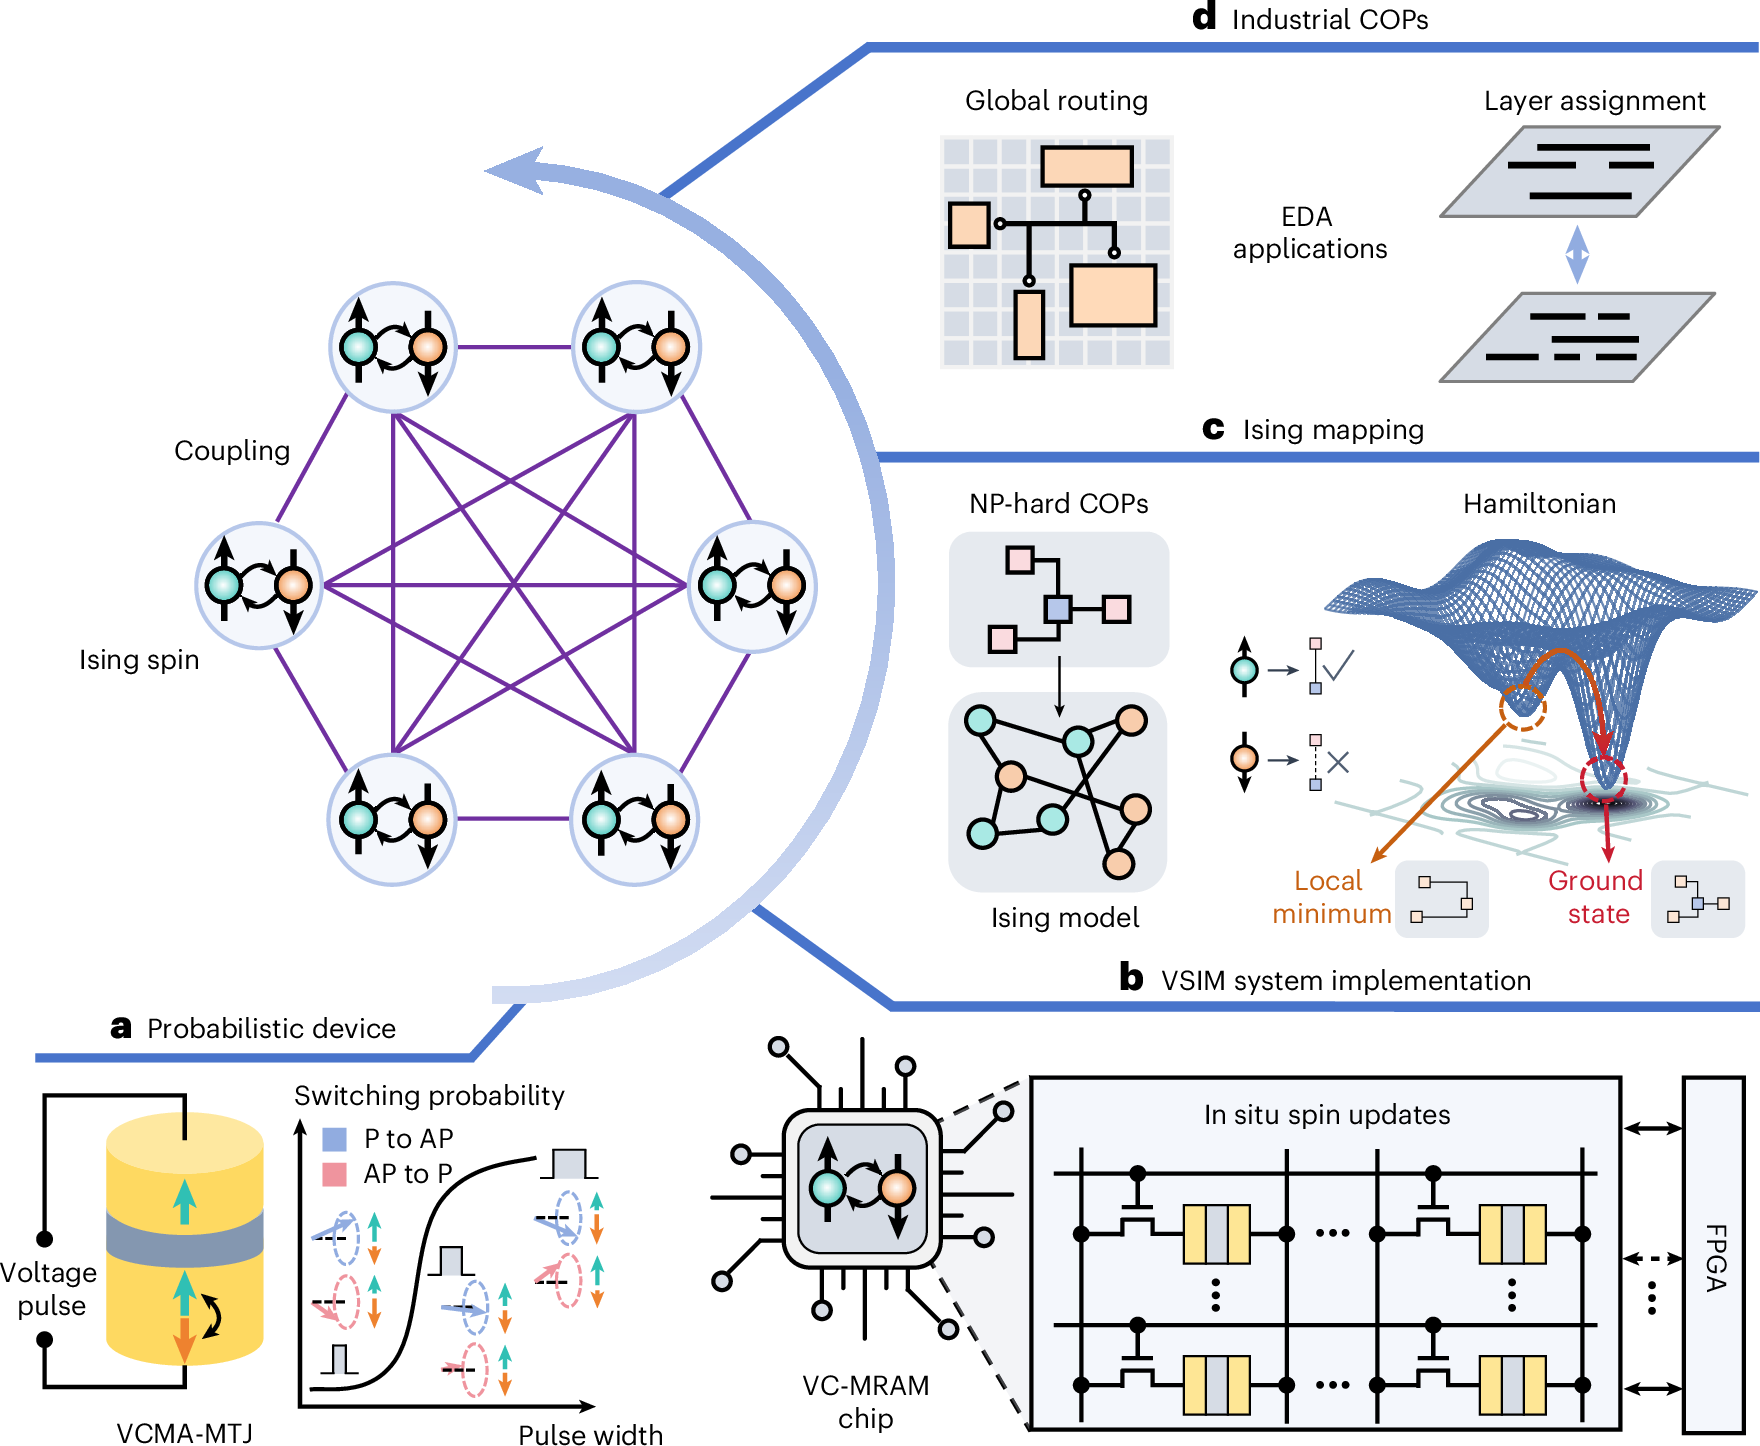
원문 Figure 1. 확률적 자기소자에서 반도체 배선 최적화까지 연결한 전체 구조

원문 Figure 1. 왼쪽은 확률적으로 방향을 바꾸는 자석 소자, 오른쪽은 문제를 Ising 에너지로 바꾸어 global routing과 layer assignment에 쓰는 흐름입니다.

한 문장으로 말하면, 이 연구는 메모리 속 작은 자석 9만 6천 개의 ‘불확실한 뒤집힘’을 오류가 아니라 최적화 계산 자원으로 사용했습니다. 반도체 칩의 블록을 선으로 연결할 때 가능한 경로를 전부 시험하면 경우의 수가 너무 많습니다. 연구팀은 선을 선택할지 말지를 +1과 -1의 spin으로 바꾸고, 좋은 배선일수록 에너지가 낮아지도록 식을 만들었습니다.

Ising Hamiltonian은 어렵게 보이지만 역할은 점수표입니다. H = -ΣJᵢⱼsᵢsⱼ - Σhᵢsᵢ에서 s는 각 선택, J는 두 선택 사이의 보상과 벌점, h는 한 선택에 주는 기울기입니다. 필수 단자를 잇고, 고리를 만들지 않고, 직각 경로를 쓰라는 규칙도 벌점으로 넣습니다.

좋은 답 = 낮은 에너지

spin 두 개가 같은 방향이어야 좋다면 그 상태의 점수가 더 낮아지도록 J의 부호를 정합니다. 식을 푼다는 말은 닫힌 해를 구했다는 뜻이 아니라, 확률적 갱신으로 낮은 점수의 답을 반복 탐색한다는 뜻입니다.

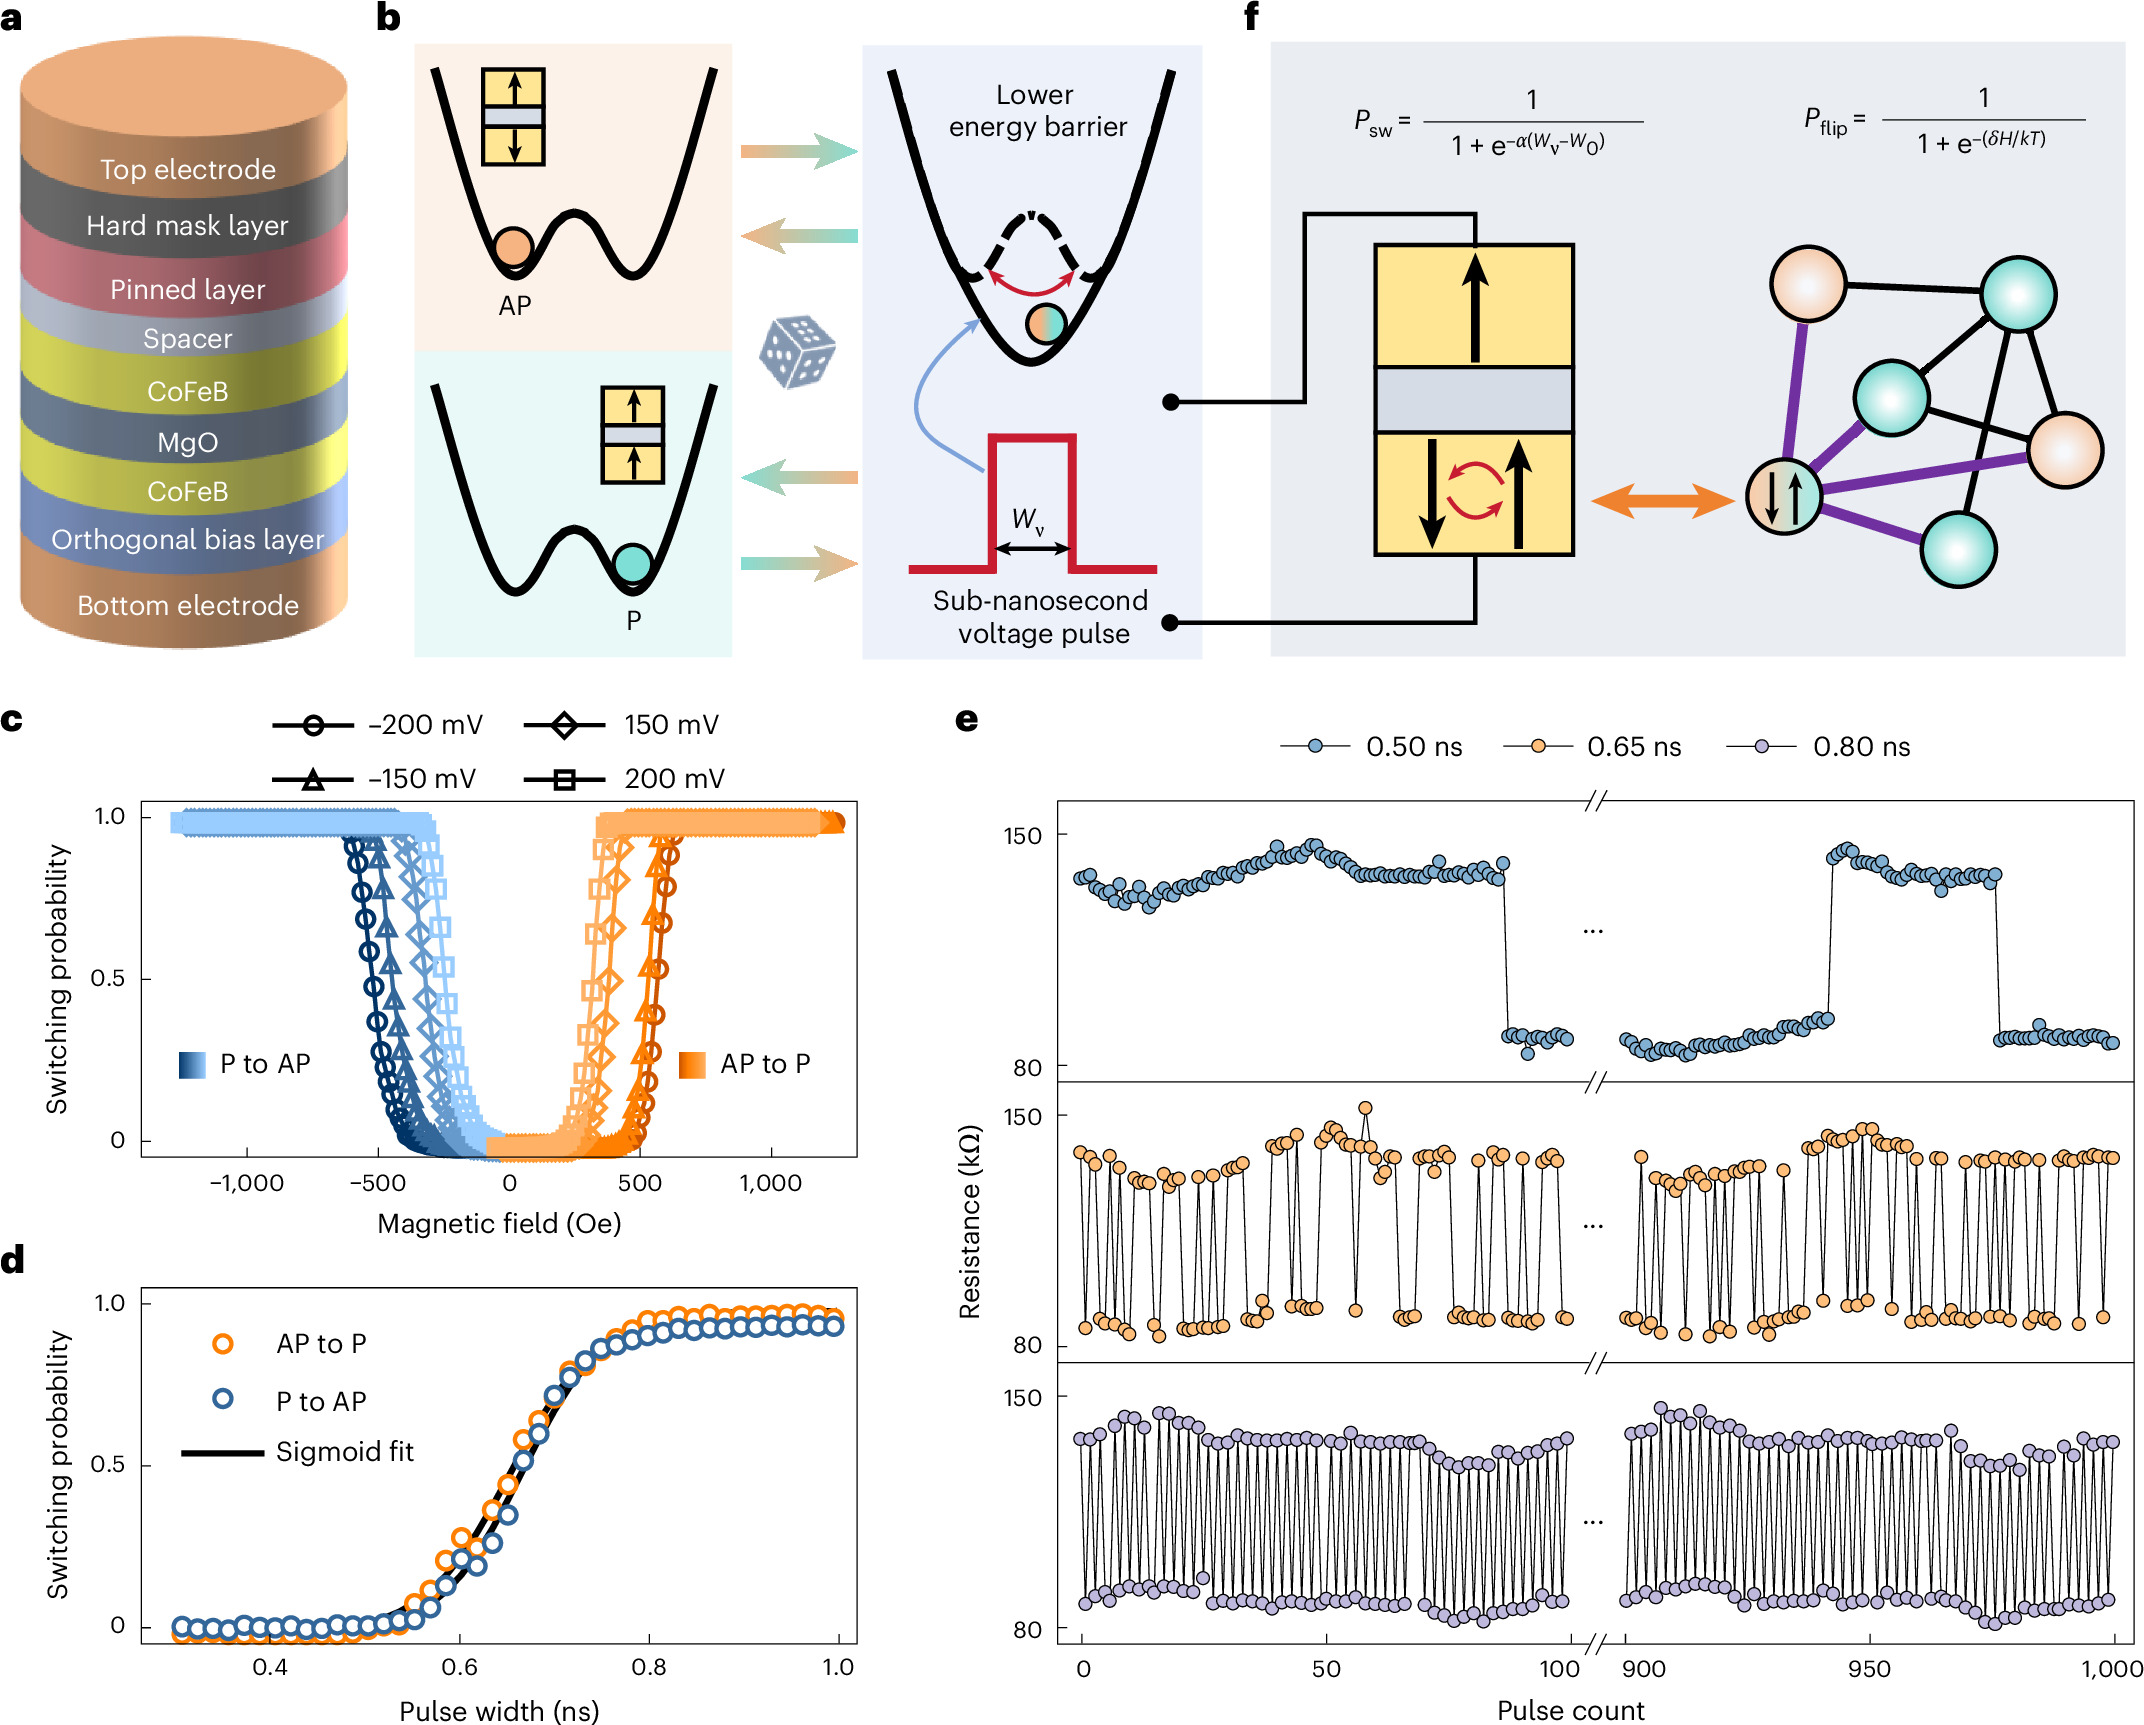
원문 Figure 2. 펄스 폭에 따라 자기터널접합의 전환 확률이 달라지는 실험

원문 Figure 2. 펄스가 짧으면 거의 안 뒤집고, 중간이면 가끔, 길면 거의 항상 뒤집힙니다. 중간 확률이 local minimum에서 빠져나오는 탐색 기능이 됩니다.

VCMA-MTJ는 자화 방향에 따라 저항이 달라지는 소자입니다. 짧은 전압 펄스로 에너지 장벽을 낮추면 방향이 바뀔 확률을 0에서 거의 1까지 조절할 수 있습니다. 논문의 0.3~1 ns는 이 소자 펄스와 업데이트의 시간 범위입니다. 40 fJ/spin도 2 V, 100 kΩ, 1 ns를 둔 소자 수준 추정입니다.

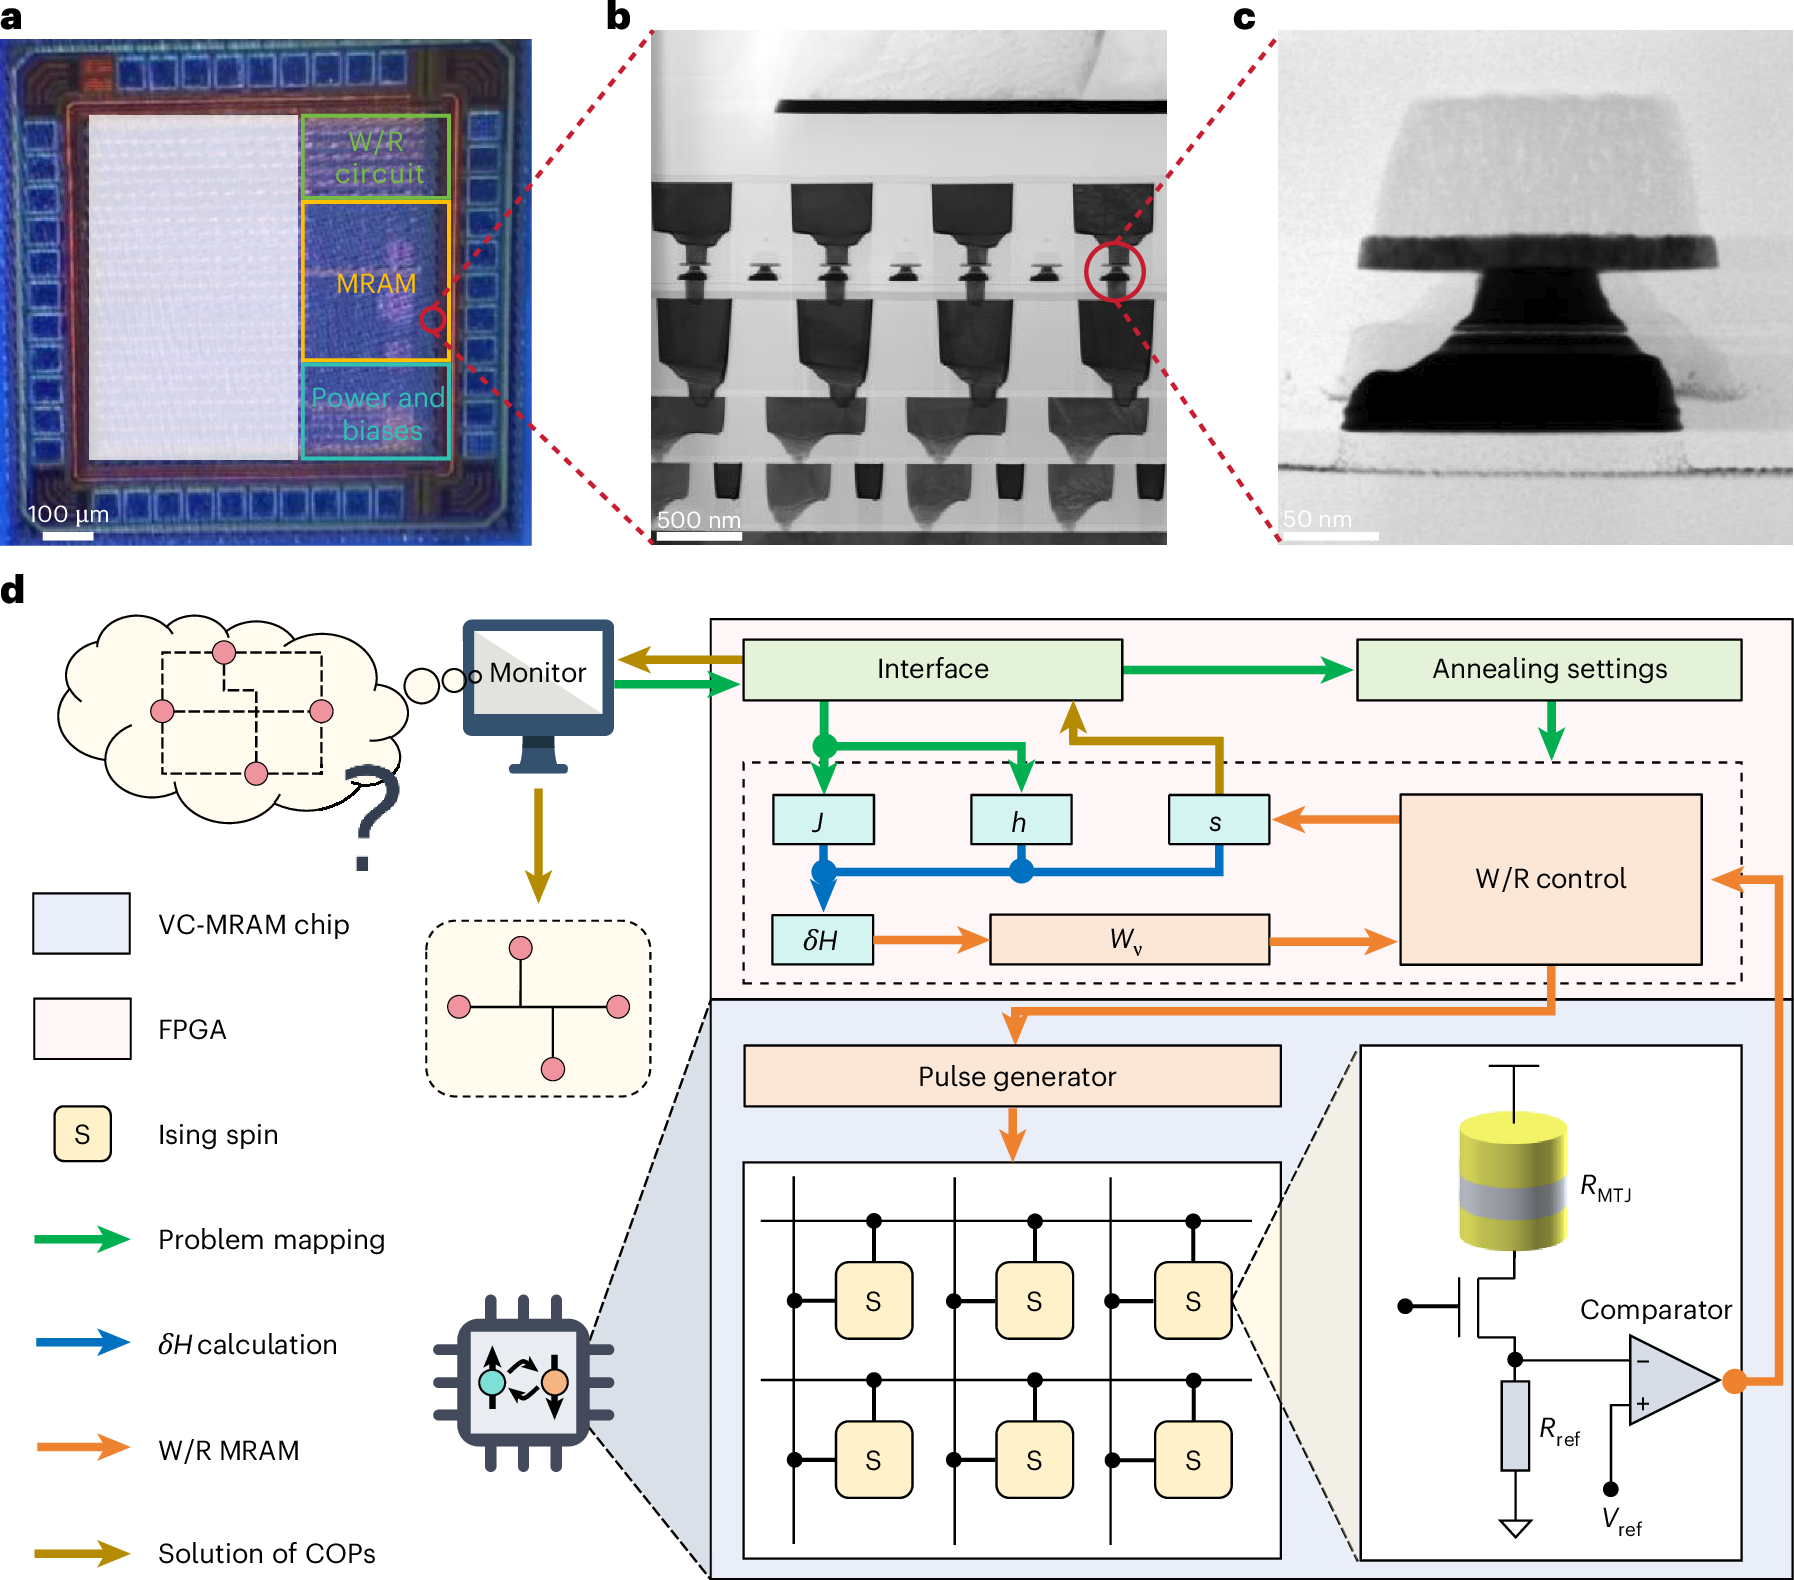
원문 Figure 3. 실제 VC-MRAM 칩과 FPGA를 연결한 시스템

원문 Figure 3. 실제 96,000-spin VC-MRAM 칩이지만 현재 실증은 FPGA가 local energy와 제어를 맡는 hybrid system입니다.

현재 측정 시스템과 미래 전망은 꼭 나눠야 합니다. 60-node dense Max-cut에서 현재 시스템은 한 iteration 45 ns, 전력 40 mW, time-to-solution 130.5 μs를 사용해 약 1.92×10⁵ solutions/s/W를 보고했습니다. 1 ns iteration과 3.45×10⁸ solutions/s/W는 모든 제어를 ASIC에 더 가깝게 통합한 미래 전망이지, 지금 칩에서 측정한 값이 아닙니다.

이 논문은 NP-hard 문제를 언제나 정확하게 빨리 푼다는 증명이 아닙니다. 특정 문제를 Ising 식으로 번역하고 좋은 해를 확률적으로 찾는 전용 하드웨어 실증입니다. 다음에는 더 큰 routing 문제에서 해 품질과 성공 확률, host와 I/O를 포함한 전체 전력, 소자 편차와 재보정, 실제 ASIC의 1 ns 동작을 확인해야 합니다.

공식 자료

라벨: , , ,

공기 중 CO₂를 배터리처럼 뽑는 원리

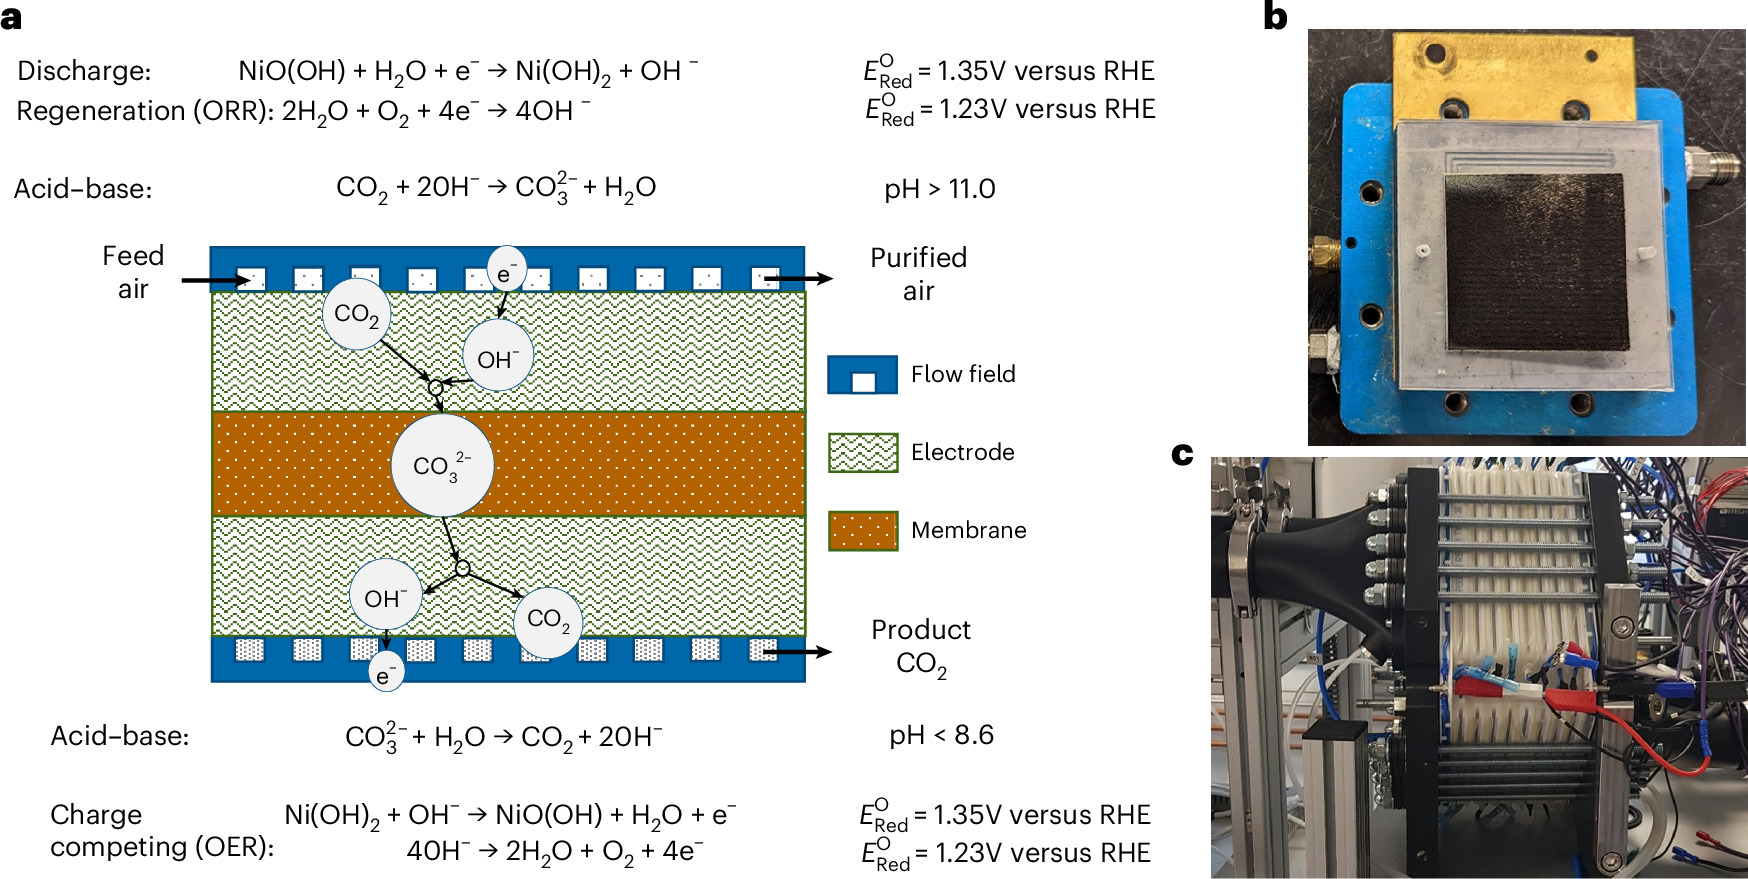
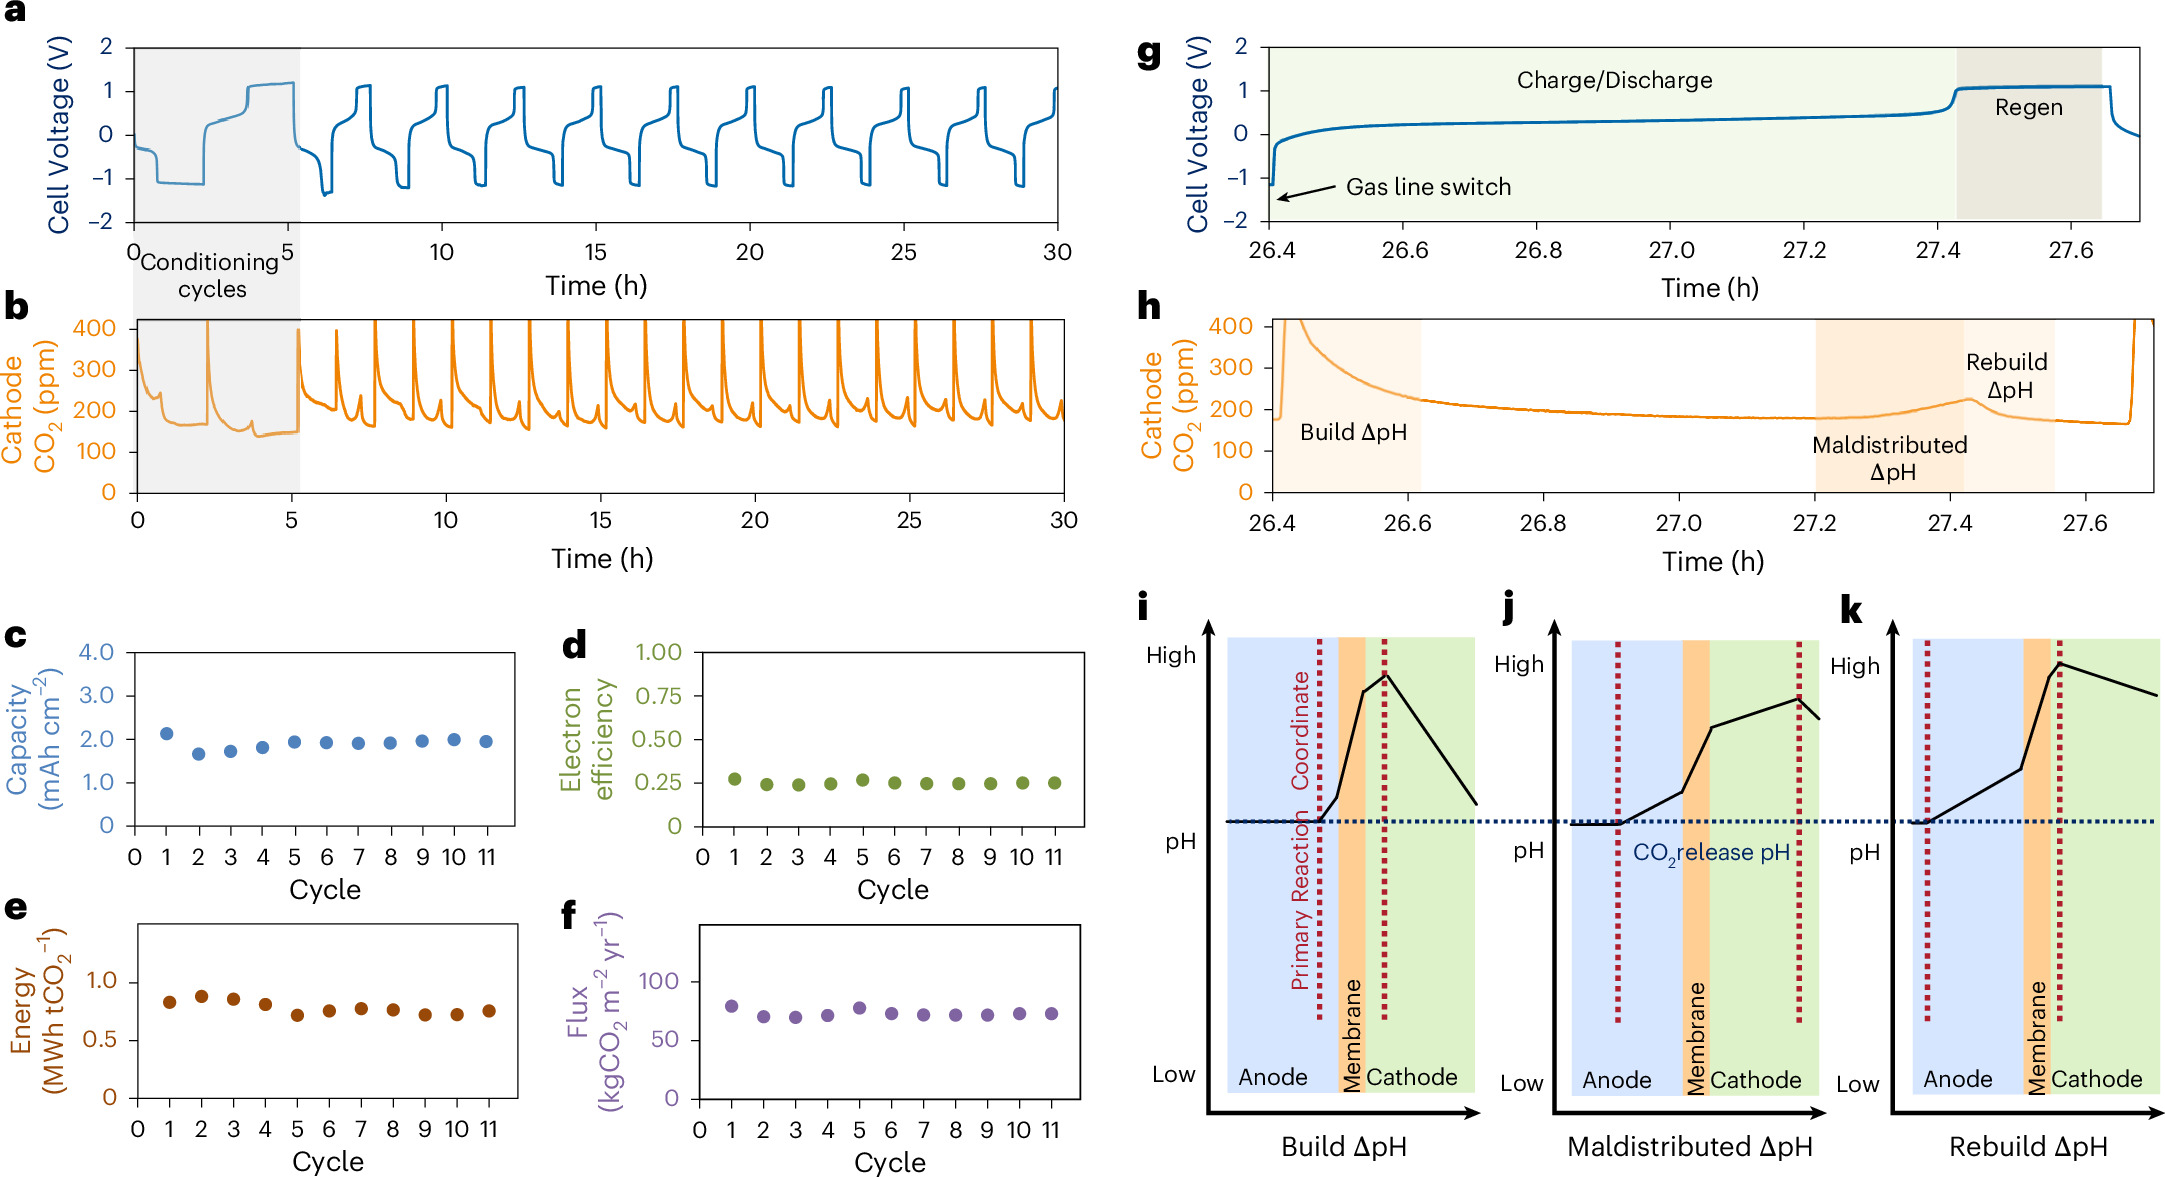
원문 Figure 1. 포집과 방출 원리, 작은 셀과 9개 셀 파일럿 스택의 실제 사진

원문 Figure 1. 왼쪽은 반응과 유로, 오른쪽 위는 25 cm² 셀, 오른쪽 아래는 9×300 cm² 스택의 실제 사진입니다. 출처: Sheth 외, Nature Energy (2026). 원본 전체를 변형 없이 해설 목적으로 인용했습니다.

한 문장으로 답하면, 이번 연구는 배터리 전극으로 물의 pH를 올렸다 내리며 공기 속 CO₂를 이온 형태로 잡고 다시 기체로 놓아주는 장치를 만들었습니다. 대기 중 CO₂는 약 400 ppm, 즉 공기 분자 100만 개 가운데 약 400개뿐입니다. 그래서 발전소 배기가스보다 훨씬 많은 공기를 통과시켜야 하고, 잡은 CO₂를 떼어내 흡착재를 다시 쓰는 재생 에너지도 필요합니다.

2026년 9월 22일 Nature Energy에 실린 연구는 수산화니켈 Ni(OH)₂와 NiOOH가 오가는 전기화학 반응을 이용했습니다. 한쪽 전극에서 OH⁻가 생기면 물이 염기성이 되고, CO₂는 중탄산이온 HCO₃⁻과 탄산이온 CO₃²⁻으로 바뀌어 용액에 머뭅니다. 반대쪽에서는 OH⁻가 줄어 pH가 낮아지고, 이온이 다시 기체 CO₂가 되어 나옵니다. 다음 반주기에는 같은 두 전극의 역할을 바꿉니다.

원문 Figure 2. 작은 셀의 전압, 출구 이산화탄소 농도, 에너지와 포집 속도

원문 Figure 2. 전압 곡선만 보는 그림이 아닙니다. 주황선은 출구 CO₂ 농도, 갈색 점은 톤당 전기, 보라색 점은 면적당 포집 속도입니다. 같은 사이클에서 모두 확인해야 합니다.

수식의 말뜻도 어렵지 않습니다. pH 한 단위 차이를 전압으로 바꾸는 Nernst 관계는 30°C 부근에서 약 0.06 V입니다. 연구팀이 계산한 최소 pH 차이 2.8을 곱하면 약 0.17 V가 됩니다. 이것은 손실이 전혀 없는 최소 전압입니다. 실제 셀에서는 반응 속도, 전기저항, 기체와 이온의 이동 때문에 더 큰 전압이 필요합니다.

최소 전압 ≈ 0.06 V × pH 차이

30°C 부근에서 0.06 × 2.8 ≈ 0.17 V. 이 값은 열역학적 하한이며 실제 소비전력과 같지 않습니다.

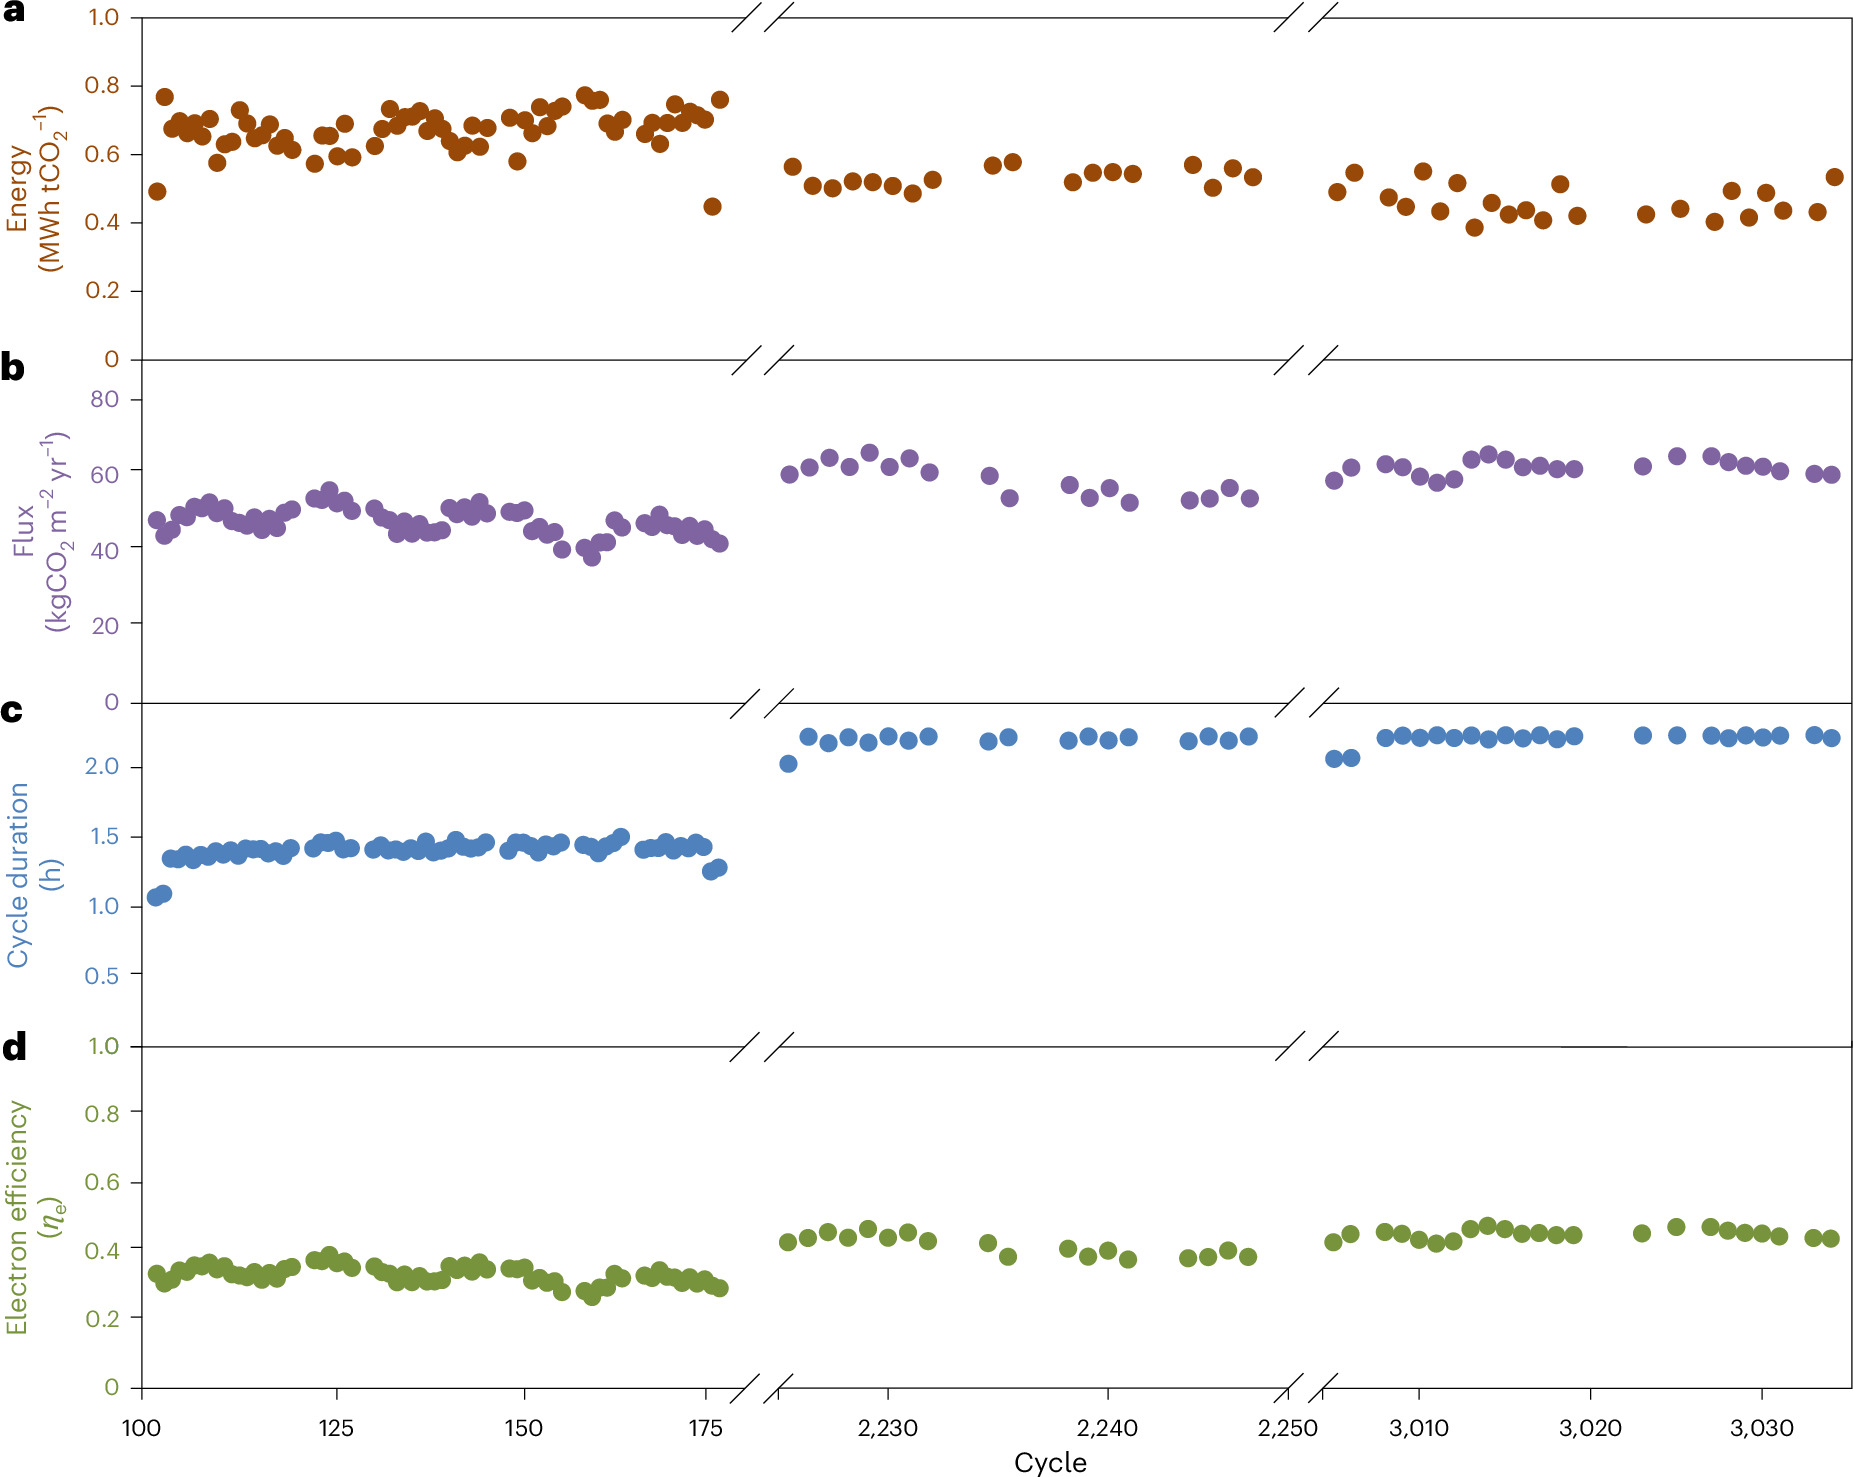
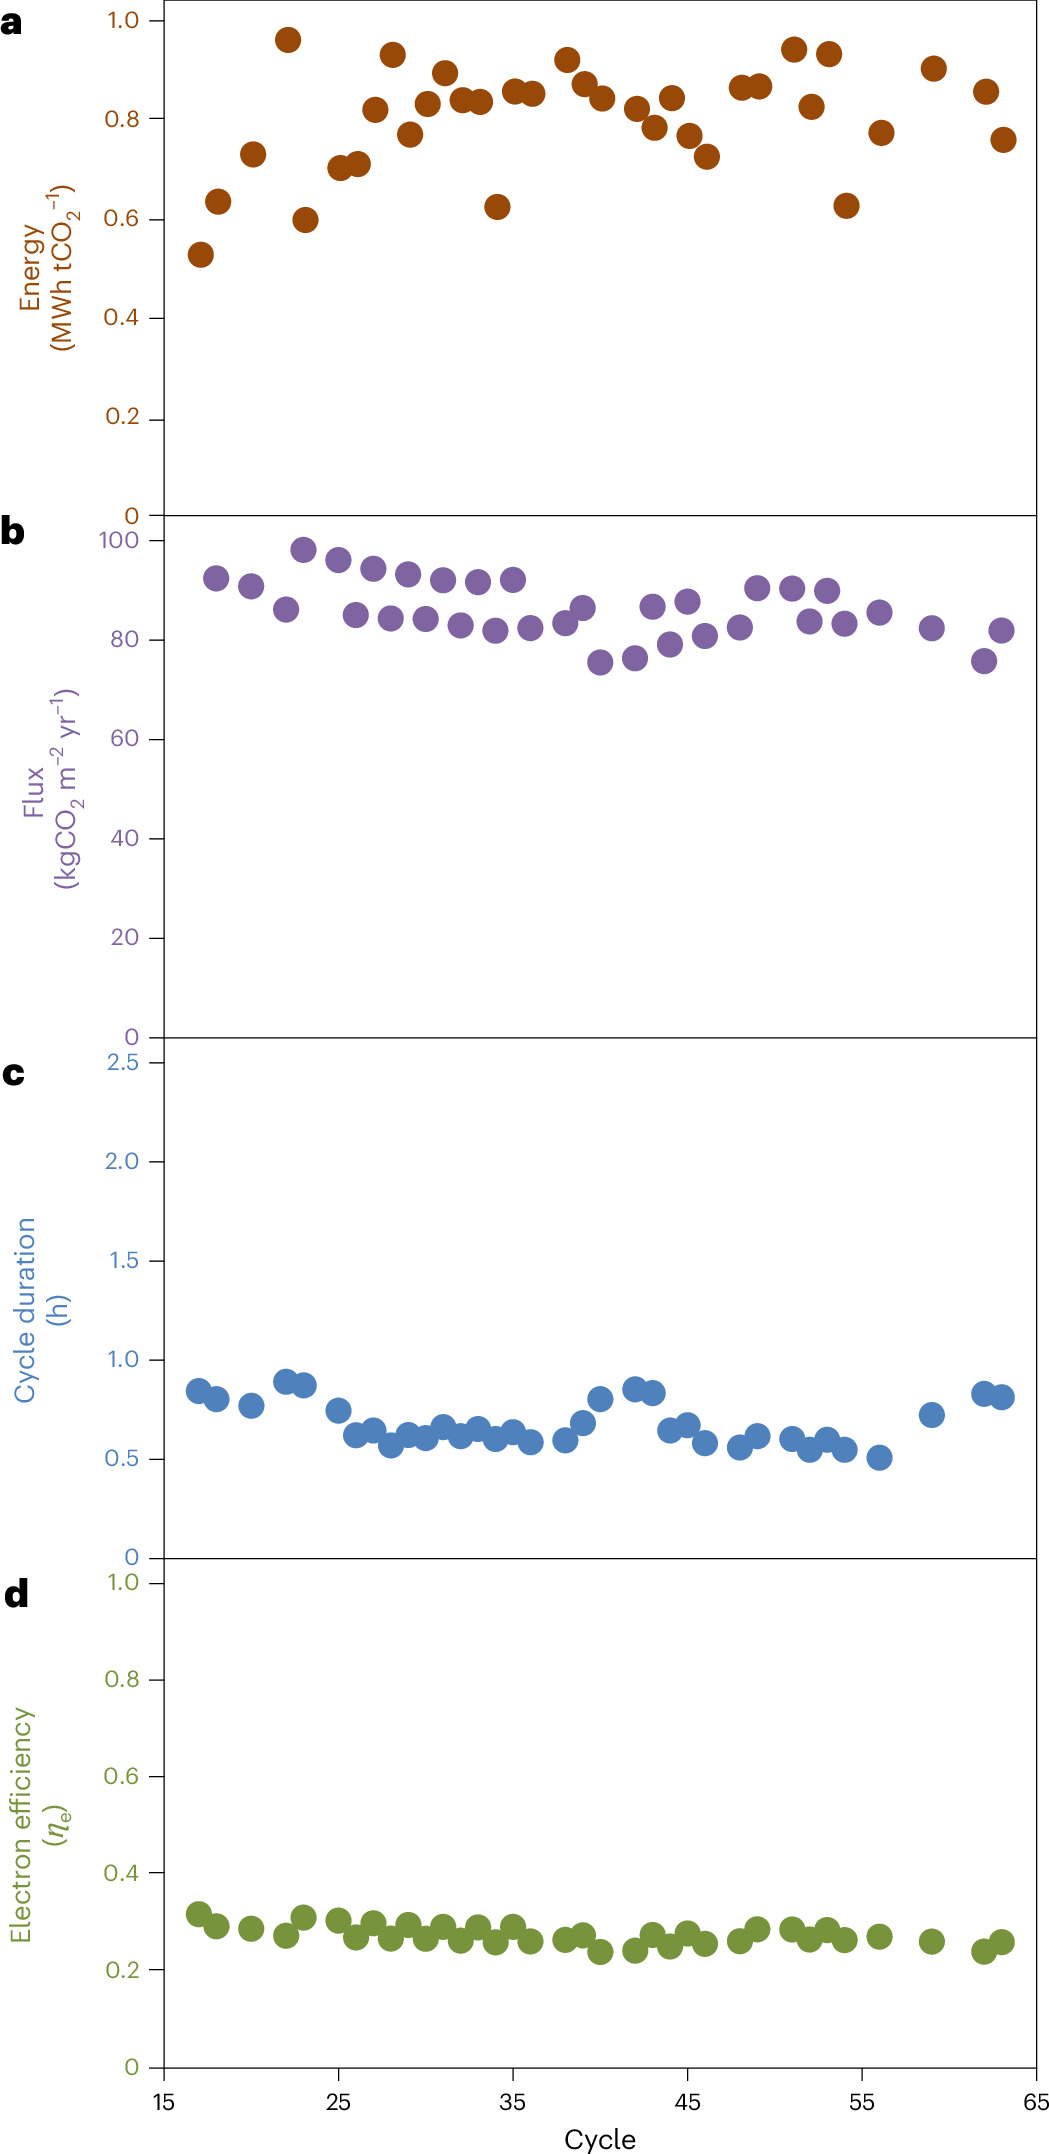
성과를 읽을 때는 두 실험을 나눠야 합니다. 25 cm²의 작은 셀은 5,000시간 운전됐고 포집과 정제 방출에 약 0.46 MWh/tCO₂를 썼습니다. 300 cm² 셀 9개를 묶은 큰 스택은 48시간 운전됐고 0.83 MWh/tCO₂를 기록했습니다. “큰 스택이 5,000시간 버텼다”는 결과가 아닙니다.

원문 Figure 3. 작은 셀의 5천 시간 내구성 시험

원문 Figure 3. 5,000시간 증거는 25 cm² 단일 셀입니다. 끊어진 가로축은 멀리 떨어진 사이클 구간을 이어 보여 줍니다.

원문 Figure 4. 9 곱하기 300 제곱센티미터 스택의 48시간 시험

원문 Figure 4. 48시간 증거는 9×300 cm² 스택입니다. Figure 3과 합쳐 ‘대형 스택 5,000시간’으로 읽으면 안 됩니다.

0.83 MWh/tCO₂의 범위도 중요합니다. 이 숫자는 스택에서 CO₂를 잡고 정제해 놓아주는 전기만 셉니다. 공기를 밀어 넣는 송풍기와, 나온 CO₂를 운송·저장용으로 압축하는 에너지는 빠져 있습니다. 따라서 다른 DAC 회사의 전체 설비 에너지와 숫자만 바로 비교하면 안 됩니다.

가장 큰 한계는 장기 대형화입니다. 별도 빠른 순환 시험에서는 16,000회 뒤 니켈 부식이 관찰됐고, 대형 스택의 다년 수명은 아직 확인되지 않았습니다. 논문의 톤당 100달러 이하 전망도 현재 실측 원가가 아닙니다. 20년 운전, 95% 가동률, 미래의 더 높은 포집속도와 대형 공장 생산을 가정한 경제성 모델입니다.

이 연구의 진짜 의미는 “DAC가 완성됐다”가 아니라, 낮은 에너지의 전기화학 반응을 5,000시간 단일 셀과 9셀 스택으로 연결했다는 데 있습니다. 다음에는 대형 스택의 수천 시간 운전, 송풍·압축을 더한 전체 에너지, 니켈과 막의 교체주기, 야외 먼지·습도 변화가 확인돼야 합니다.

독자가 숫자를 판단할 때는 네 가지를 함께 보면 됩니다. 들어간 공기의 CO₂ 농도, 에너지에 포함한 장치 범위, 장치의 면적과 운전 시간, 그리고 실측값인지 미래 가정인지입니다. 이번 0.83 MWh/tCO₂는 몰 단위로 약 132 kJ/molCO₂와 같은 값이지만, 전기요금이나 톤당 제거 비용 그 자체는 아닙니다.

공식 자료

라벨: , , ,

2026년 9월 13일 일요일

동영상 한 편에서 움직이는 3D를 읽는 AI

한 문장으로 먼저

D4RT는 동영상의 픽셀을 단순히 따라가는 모델이 아니라, 한 영상에서 깊이·물체의 움직임·카메라 움직임을 함께 추정하려는 4D 컴퓨터 비전 연구입니다. 여기서 4D는 새로운 공간축이 아니라 3차원 장면이 시간에 따라 어떻게 변하는가를 뜻합니다.

동영상 프레임을 encoder가 장면 표현으로 바꾼 뒤 픽셀·시간·카메라 관점을 질의하는 D4RT의 교육용 구조도

동영상은 평면 픽셀의 연속입니다. 사람이 화면에서 오른쪽으로 움직였을 때, 그 사람이 실제로 움직인 것인지 카메라가 움직인 것인지, 혹은 사람이 다른 물체 뒤에 잠시 가려진 것인지 픽셀만으로는 바로 알기 어렵습니다. 로봇이나 AR 안경에는 이 구분이 중요합니다. 사람이 어디에 있고 다음 순간 어디로 갈지, 가상 물체를 실제 바닥에 안정적으로 붙일 수 있는지를 알아야 하기 때문입니다.

기존에는 깊이를 구하는 모델, 점의 움직임을 추적하는 모델, 카메라 위치를 추정하는 모델을 따로 이어 붙이는 경우가 많았습니다. D4RT는 동영상을 먼저 하나의 장면 표현으로 압축한 뒤, “이 프레임의 이 픽셀이 다른 시각에는 3D 공간 어디에 있는가?”라는 질문을 던지는 방식을 택합니다. 같은 질문 틀을 여러 번 쓰면 점의 3D 궤적, 깊이 지도, 점구름, 카메라 자세를 얻을 수 있습니다.

3D 다음의 4D는 무엇이 다른가

Google DeepMind 공식 작동 원리 영상. 영상을 읽는 인코더가 공통 장면 표현을 만들고, 디코더가 선택한 픽셀의 위치를 시각·카메라 관점에 맞춰 답하는 흐름을 살펴보자. 출처와 전체 설명 · 영상 직접 열기

한 순간의 모양과 깊이를 다루는 정적인 3D 재구성에 시간에 따른 점의 대응 관계를 더한 동적인 4D 재구성을 대비한 교육용 그림

정적인 3D 재구성은 “지금 이 점이 카메라에서 얼마나 떨어져 있나”를 주로 묻습니다. 4D 재구성은 여기에 “같은 점이 시간이 지나 어디로 갔나”, “카메라가 움직여 배경이 흐른 것인가”, “물체가 가려졌다가 다시 나타난 것인가”를 더합니다.

D4RT의 강점은 필요한 질문을 필요한 만큼만 한다는 데 있습니다. 영상을 읽는 무거운 encoder는 장면 전체의 geometry와 motion을 담은 표현을 한 번 만들고, 이후 decoder는 특정 픽셀·시각·관점에 관한 많은 질의를 병렬로 답할 수 있습니다. 전체 장면을 매번 처음부터 계산하는 방식보다 빠를 수 있는 구조적 이유입니다.

DeepMind의 공식 설명은 여러 벤치마크에서 이전 방법보다 18배에서 300배 빠르다고 소개합니다. 예시로 한 TPU에서 1분 영상을 약 5초에 처리했다는 사례도 제시합니다. 그러나 이 숫자는 모든 스마트폰이나 모든 로봇에서 같은 배율이 나온다는 뜻이 아닙니다. 하드웨어, 해상도, 질의 수, 가림 정도, 전처리·후처리 여부가 다르면 실제 지연 시간도 달라집니다.

로봇과 AR에는 어디까지 도움이 될까

MPI Sintel 점구름 재구성 비교: 3D Fidelity는 MapAnything 0.282, VGGT 0.420, MegaSaM 0.469, SpatialTrackerV2 0.625, π3 0.861, D4RT 1.091. 높을수록 좋다.
Google DeepMind의 MPI Sintel 점구름 재구성 비교. 세로축은 정확도 백분율이 아니라 2 − L1 오차로 정의한 3D Fidelity다. 막대가 높으면 이 평가에서 복원한 3D 위치의 오차가 작다는 뜻이며, 1.091을 109.1% 정확도로 읽으면 안 된다. 출처와 평가 설명 · 이미지를 누르면 원본 확대.

로봇이 사람과 물체가 움직이는 공간에서 안전하게 움직이려면 공간 인식이 필요합니다. D4RT 같은 모델은 가려진 점의 위치를 추정하고, 카메라 흔들림과 물체 움직임을 분리하며, 장면의 깊이를 제공하는 입력이 될 수 있습니다. AR에서는 가상 표시가 실제 책상·바닥에 흔들리지 않고 붙도록 돕는 기초 정보가 될 수 있습니다.

하지만 인식이 곧 행동은 아닙니다. 컵을 잡는 로봇에는 물체 분할, 힘 제어, 충돌 검사, 지연 대응, 실패 시 안전 정지가 더 필요합니다. 시각 벤치마크의 점수가 높아도 어두운 공장, 반사 유리, 많은 사람이 서로 가리는 장면에서 안전하다는 보증은 아닙니다.

그래서 D4RT를 ‘세계 모델을 완성한 AI’라고 부르면 과장입니다. 이 연구가 직접 보여 준 것은 동영상에서 움직이는 3D 장면을 하나의 query 기반 구조로 복원·추적하는 방법과 그 벤치마크 성과입니다. 실제 로봇·AR 제품이 되려면 독립 재현, 현실 환경의 강건성, 전력과 지연, 안전 제어까지 이어져야 합니다.

공식 데모, 벤치마크 숫자의 뜻, 4D와 월드 모델을 구분하는 이유는 GitHub Pages 전체 해설에서 자세히 정리했습니다.

공식 자료

작동 원리 영상과 MPI Sintel 차트의 출처는 Google DeepMind이며 공식 서버에서 연결해 표시합니다. 두 한국어 설명 도식은 JJo가 직접 제작했습니다.

라벨: , , ,

확산 모델은 그림을 더 정확히 만들 수 있을까?

한 문장으로 먼저

FORS는 이미지 생성기를 당장 몇 배 빠르게 만든 제품이 아니라, 확산 모델이 아주 작은 오차까지 맞춰야 할 때 필요한 계산 단계를 수학적으로 크게 줄일 수 있음을 보인 연구입니다. 핵심은 “속도가 빨라졌다”보다 정확도 요구가 높아질 때 계산량이 어떻게 늘어나는가에 있습니다.

목표 오차를 더 작게 할 때 기존 다항식 의존과 FORS의 polylog 의존이 이론적으로 다르게 증가할 수 있음을 비교하는 교육용 그림

확산 모델은 처음부터 사진을 그리지 않습니다. 무작위 점무늬에서 시작해 “지금 이 점을 어느 방향으로 조금 움직이면 더 그럴듯한 사진에 가까워질까?”를 여러 번 묻습니다. 이때 방향을 알려 주는 신호를 score라고 합니다. 한 번 묻고 조금 움직이는 과정을 많이 반복하면 노이즈가 이미지가 됩니다.

문제는 정확도를 높일수록 반복 횟수가 빠르게 늘 수 있다는 점입니다. 논문에서는 허용 오차를 δ라고 쓰는데, δ를 매우 작게 만들수록 기존 방식은 단계 수가 1/δ의 다항식처럼 커질 수 있습니다. FORS는 특정 조건이 맞으면 이 의존성을 polylog(1/δ)로 바꿀 수 있음을 보입니다. 이름은 어렵지만 ‘더 엄격한 정밀도를 요구해도 단계 수가 폭발하지 않을 길이 있는가’를 다룬 연구라고 생각하면 됩니다.

FORS는 정확히 무엇을 하나

FORS는 First-Order Rejection Sampling의 줄임말입니다. 보통 거절 샘플링은 후보 하나를 뽑은 뒤 목표 분포에 얼마나 어울리는지 판단해 받아들이거나 버리는 방법입니다. 이 판단에는 보통 분포의 밀도값이 편리합니다. 하지만 확산 모델은 밀도값 자체보다 “어느 방향이 더 그럴듯한가”라는 score를 쉽게 제공합니다.

FORS의 아이디어는 그 방향 정보만으로도 거절 샘플링을 구현할 수 있게 하자는 것입니다. 논문은 이론적으로 score 질의만 이용해 높은 정확도의 샘플을 얻는 방법을 보입니다. 여기서 score oracle은 비밀 장치가 아니라, 질문하면 방향 정보를 답해 주는 함수나 학습된 모델을 뜻합니다.

목표 분포에서 score 추정기, FORS의 후보 채택·거절 과정, 고정확도 샘플로 이어지는 교육용 흐름도

가장 중요한 단서는 조건입니다. 목표 오차 δ가 작아질수록 score 추정 자체도 대략 Õ(δ) 수준으로 정확해야 합니다. 따라서 샘플링 알고리즘만 바꾸면 어떤 모델이든 자동으로 고정확도가 되는 것은 아닙니다. 이론적으로 단계 수가 줄어도, 한 단계에서 score를 몇 번 물어야 하는지와 모델 한 번 실행하는 실제 비용은 따로 측정해야 합니다.

이 연구를 어떻게 읽으면 좋을까

이 논문이 증명한 것은 이미지 품질, 프롬프트 충실도, 사용자 대기 시간을 직접 비교한 결과가 아닙니다. 목표 분포와의 수학적 거리를 작게 만들 때의 복잡도 결과입니다. 그래서 “새 솔버가 Stable Diffusion보다 빠르다”는 식의 결론은 아직 이릅니다.

그렇지만 과학 계산·통계 샘플링처럼 매우 작은 오차가 중요한 분야에서는 이 차이가 의미 있을 수 있습니다. 또 일반 로그 오목 분포에서도 gradient 정보만으로 같은 종류의 고정확도 결과를 얻는다는 점은 확산 모델 밖의 샘플링 이론에도 연결됩니다.

다음에 확산 모델 속도 기사를 볼 때는 단계 수만 보지 말고, 같은 모델·같은 해상도·같은 품질 기준에서 실제 시간이 줄었는지, score 추정 오차 조건이 무엇인지, 메모리와 전력까지 포함했는지를 확인하면 좋습니다. FORS는 그 검증이 필요한 미래 솔버의 설계 공간을 넓힌 연구입니다.

증명 조건, score와 밀도의 차이, 실제 제품 성능으로 바로 번역할 수 없는 이유는 GitHub Pages 전체 해설에서 이어서 읽을 수 있습니다.

공식 자료

본문의 두 그림은 JJo가 직접 만든 설명 도식입니다. 논문 Figure의 별도 자유 이용 허락을 확인하지 못해 원본 도표는 재배포하지 않았고, 실제 제품의 속도·품질 수치를 그린 그래프도 아닙니다.

라벨: , , ,

확산 LLM은 왜 아무 순서로 쓰면 추론을 놓칠까?

한 문장으로 먼저

AI가 문장을 더 자유롭게 채울 수 있다고 해서 수학·코드 문제를 항상 더 잘 푸는 것은 아닙니다. JustGRPO는 확산 언어 모델을 보상으로 훈련할 때만 답을 왼쪽에서 오른쪽으로 쓰게 했고, 저자들의 공개 실험에서는 그 편이 더 다양한 정답 경로를 남겼다고 보고했습니다.

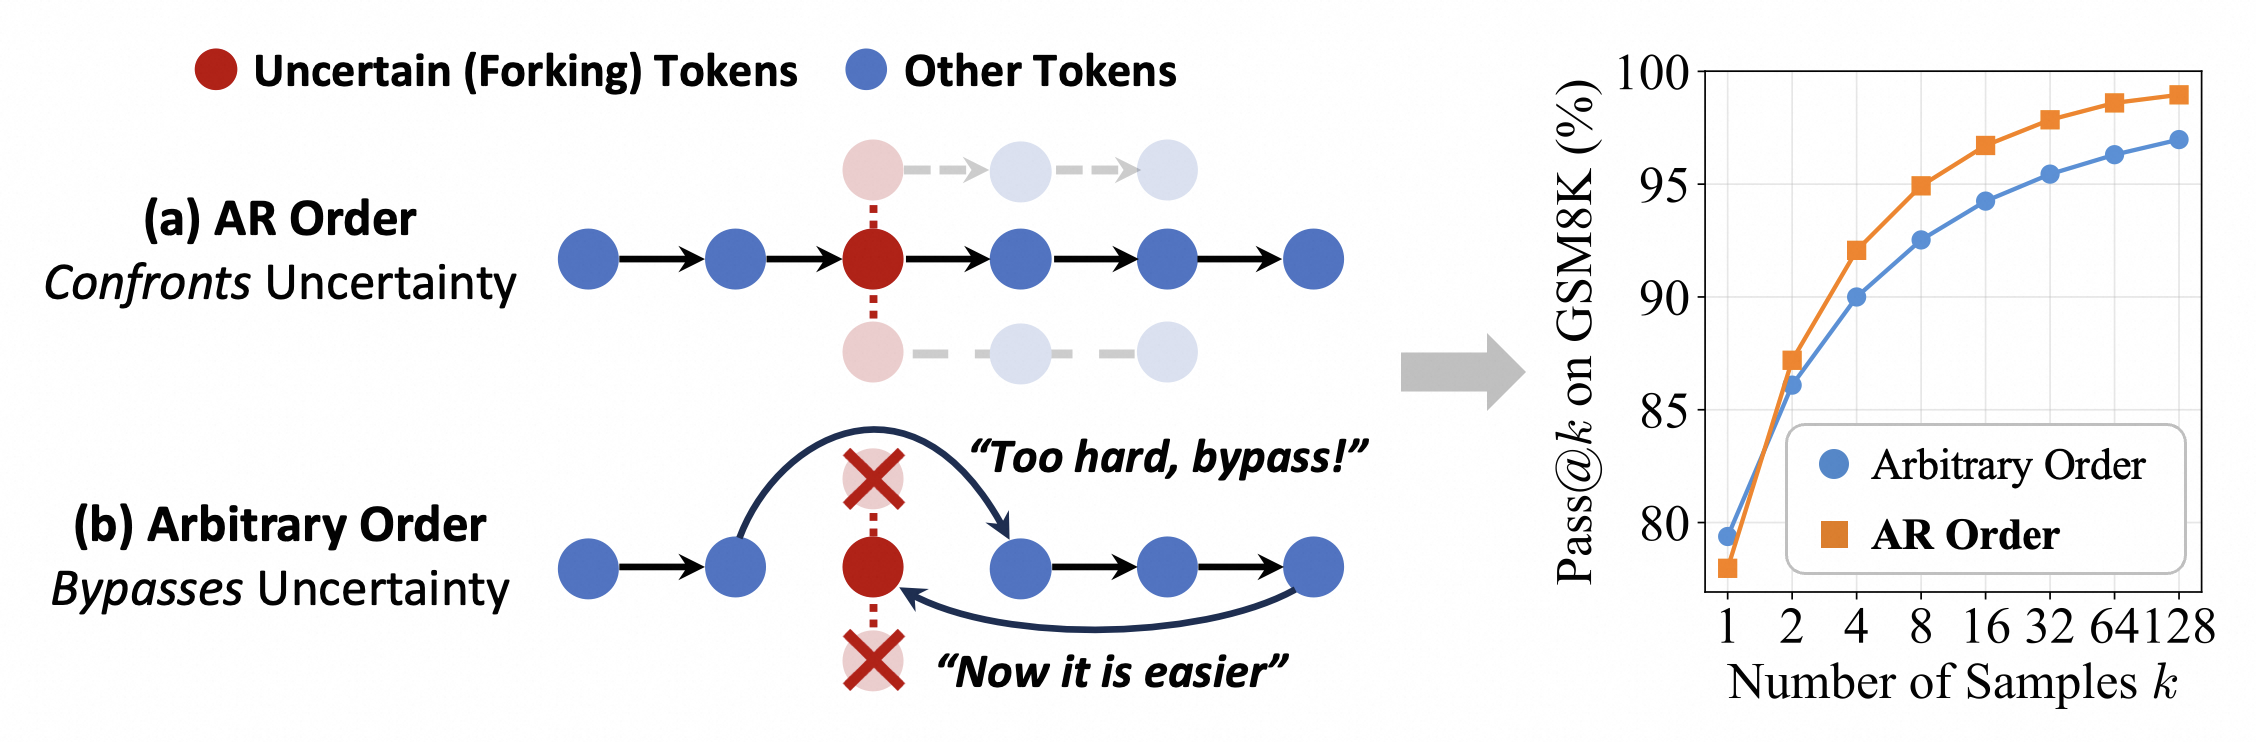
JustGRPO 저자들이 공개한 원본 그림: 임의 순서 생성이 논리적으로 중요한 빈칸을 미루면 여러 풀이 경로가 줄 수 있다는 설명

보통 ChatGPT 같은 언어 모델은 앞에서 쓴 말 다음에 올 말을 고르며 문장을 만듭니다. 이를 왼쪽에서 오른쪽으로 한 칸씩 쓰는 방식이라고 생각하면 됩니다. 반면 확산 언어 모델은 문장 전체의 빈칸을 보고, 자신 있는 위치부터 먼저 채울 수 있습니다. 지우개로 일부가 가려진 문장에서 쉬운 단어부터 복원하는 느낌에 가깝습니다.

겉으로는 빈칸을 마음대로 채우는 쪽이 더 똑똑해 보입니다. 하지만 수학 풀이와 코드 작성에서는 그러므로, 따라서, 조건 분기처럼 앞뒤 논리를 이어 주는 짧은 부분이 중요합니다. 연구진은 모델이 확신 높은 숫자나 흔한 표현을 먼저 채우면, 이런 어려운 연결 지점을 나중에 억지로 맞춰 넣게 될 수 있다고 설명합니다. 이미 답의 뼈대가 정해진 뒤에 논리를 끼워 넣는 셈입니다.

여기서 나오는 Pass@k는 답을 k번 만들었을 때 하나라도 맞는 답이 있을 가능성을 보는 지표입니다. 같은 문제를 네 번 풀어도 비슷한 오답만 반복하면 기회가 늘지 않습니다. 반대로 서로 다른 방법을 시도하면 하나가 맞을 수 있습니다. JustGRPO가 말하는 핵심은 ‘더 많은 답을 만들자’가 아니라, 답이 너무 이른 시점에 한 방향으로 굳지 않게 하자에 가깝습니다.

JustGRPO는 정확히 무엇을 바꿨나

이름이 복잡하지만 핵심 변경은 작습니다. 같은 문제에 답안 여러 개를 만들고, 수학 답이 맞는지 또는 코드가 테스트를 통과하는지 확인합니다. 더 좋은 답에 더 높은 점수를 주고 다음 학습에서 그 선택을 더 자주 하도록 조정합니다. 이를 보상 학습이라고 합니다.

JustGRPO는 이 학습 과정에서만 답을 한 줄씩 차례로 만들게 합니다. 사용자가 답을 받을 때 확산 모델의 병렬 복원 방식을 완전히 없앤 것은 아닙니다. 따라서 “확산 LLM을 보통 언어 모델로 바꿨다”는 설명보다 “보상 학습 때의 답안 생성 순서를 단순하게 정했다”가 정확합니다.

질문에서 여러 답안을 만들고 검증 보상으로 업데이트한 뒤, 실제 추론에서는 병렬 생성 선택지가 남는 과정을 설명하는 교육용 흐름도

저자 공개 저장소의 길이 256 설정에서 수학·코드 네 과제의 결과는 GSM8K 89.1, MATH-500 45.1, HumanEval 49.4, MBPP 52.4였습니다. 숫자는 서로 다른 시험의 점수라서 89.1이 49.4보다 두 배 낫다는 뜻은 아닙니다. 중요한 것은 동일 연구의 설정 안에서, 임의 순서의 장점을 무조건 살리는 대신 학습 경로를 단순화했을 때 강한 결과가 나왔다는 점입니다.

여기까지는 알 수 있고, 여기부터는 아직 모른다

ICML 2026 Outstanding Paper 수상과 공개 코드·체크포인트는 이 연구를 살펴볼 좋은 이유입니다. 다만 이 결과가 모든 대화, 창작, 과학 연구, 실제 서비스에 그대로 적용된다는 뜻은 아닙니다. 이 연구는 수학과 코드 벤치마크를 중심으로 했고, 여러 답 중 하나를 고를 수 있는 Pass@k도 실제 사용자가 한 번 받는 답의 안전성이나 유용성과는 다릅니다.

또한 이 AI가 자기 목적을 정해 스스로 진화한 것은 아닙니다. 사람이 문제와 채점 규칙, 학습 조건을 정했고 모델은 그 안에서 더 높은 보상을 받은 선택을 배우는 것입니다. 다음 AI 뉴스를 볼 때는 무엇을 바꿨는지, 한 번의 정답률인지 여러 번 시도의 지표인지, 같은 비용과 조건에서 비교했는지, 코드와 평가 규칙이 공개됐는지를 확인하면 좋습니다.

수식과 원본 결과 그림, AR·확산 생성의 차이를 더 자세히 보고 싶다면 GitHub Pages 전체 해설을 이어서 읽을 수 있습니다.

공식 자료

첫 그림은 LeapLab·Tsinghua University가 JustGRPO 저장소에 MIT 라이선스로 공개한 원본 PNG이고 변경하지 않았습니다. 두 번째 그림은 JJo가 학습과 추론의 차이를 설명하기 위해 직접 만든 도식이며, 실제 성능·비용 비율을 나타내지 않습니다.

라벨: , , ,

2026년 9월 9일 수요일

Navier–Stokes 방정식이란? AI가 난제를 풀었다는 말 쉽게 보기

한 문장으로 먼저

Navier–Stokes 방정식은 물과 공기의 흐름을 설명하는 식입니다. OpenAI는 이 식의 3차원 해가 특정 조건에서 매끄러움을 잃을 수 있다는 증명 후보를 공개했지만, 아직 Clay Mathematics Institute가 공식 해결로 인정한 것은 아닙니다.

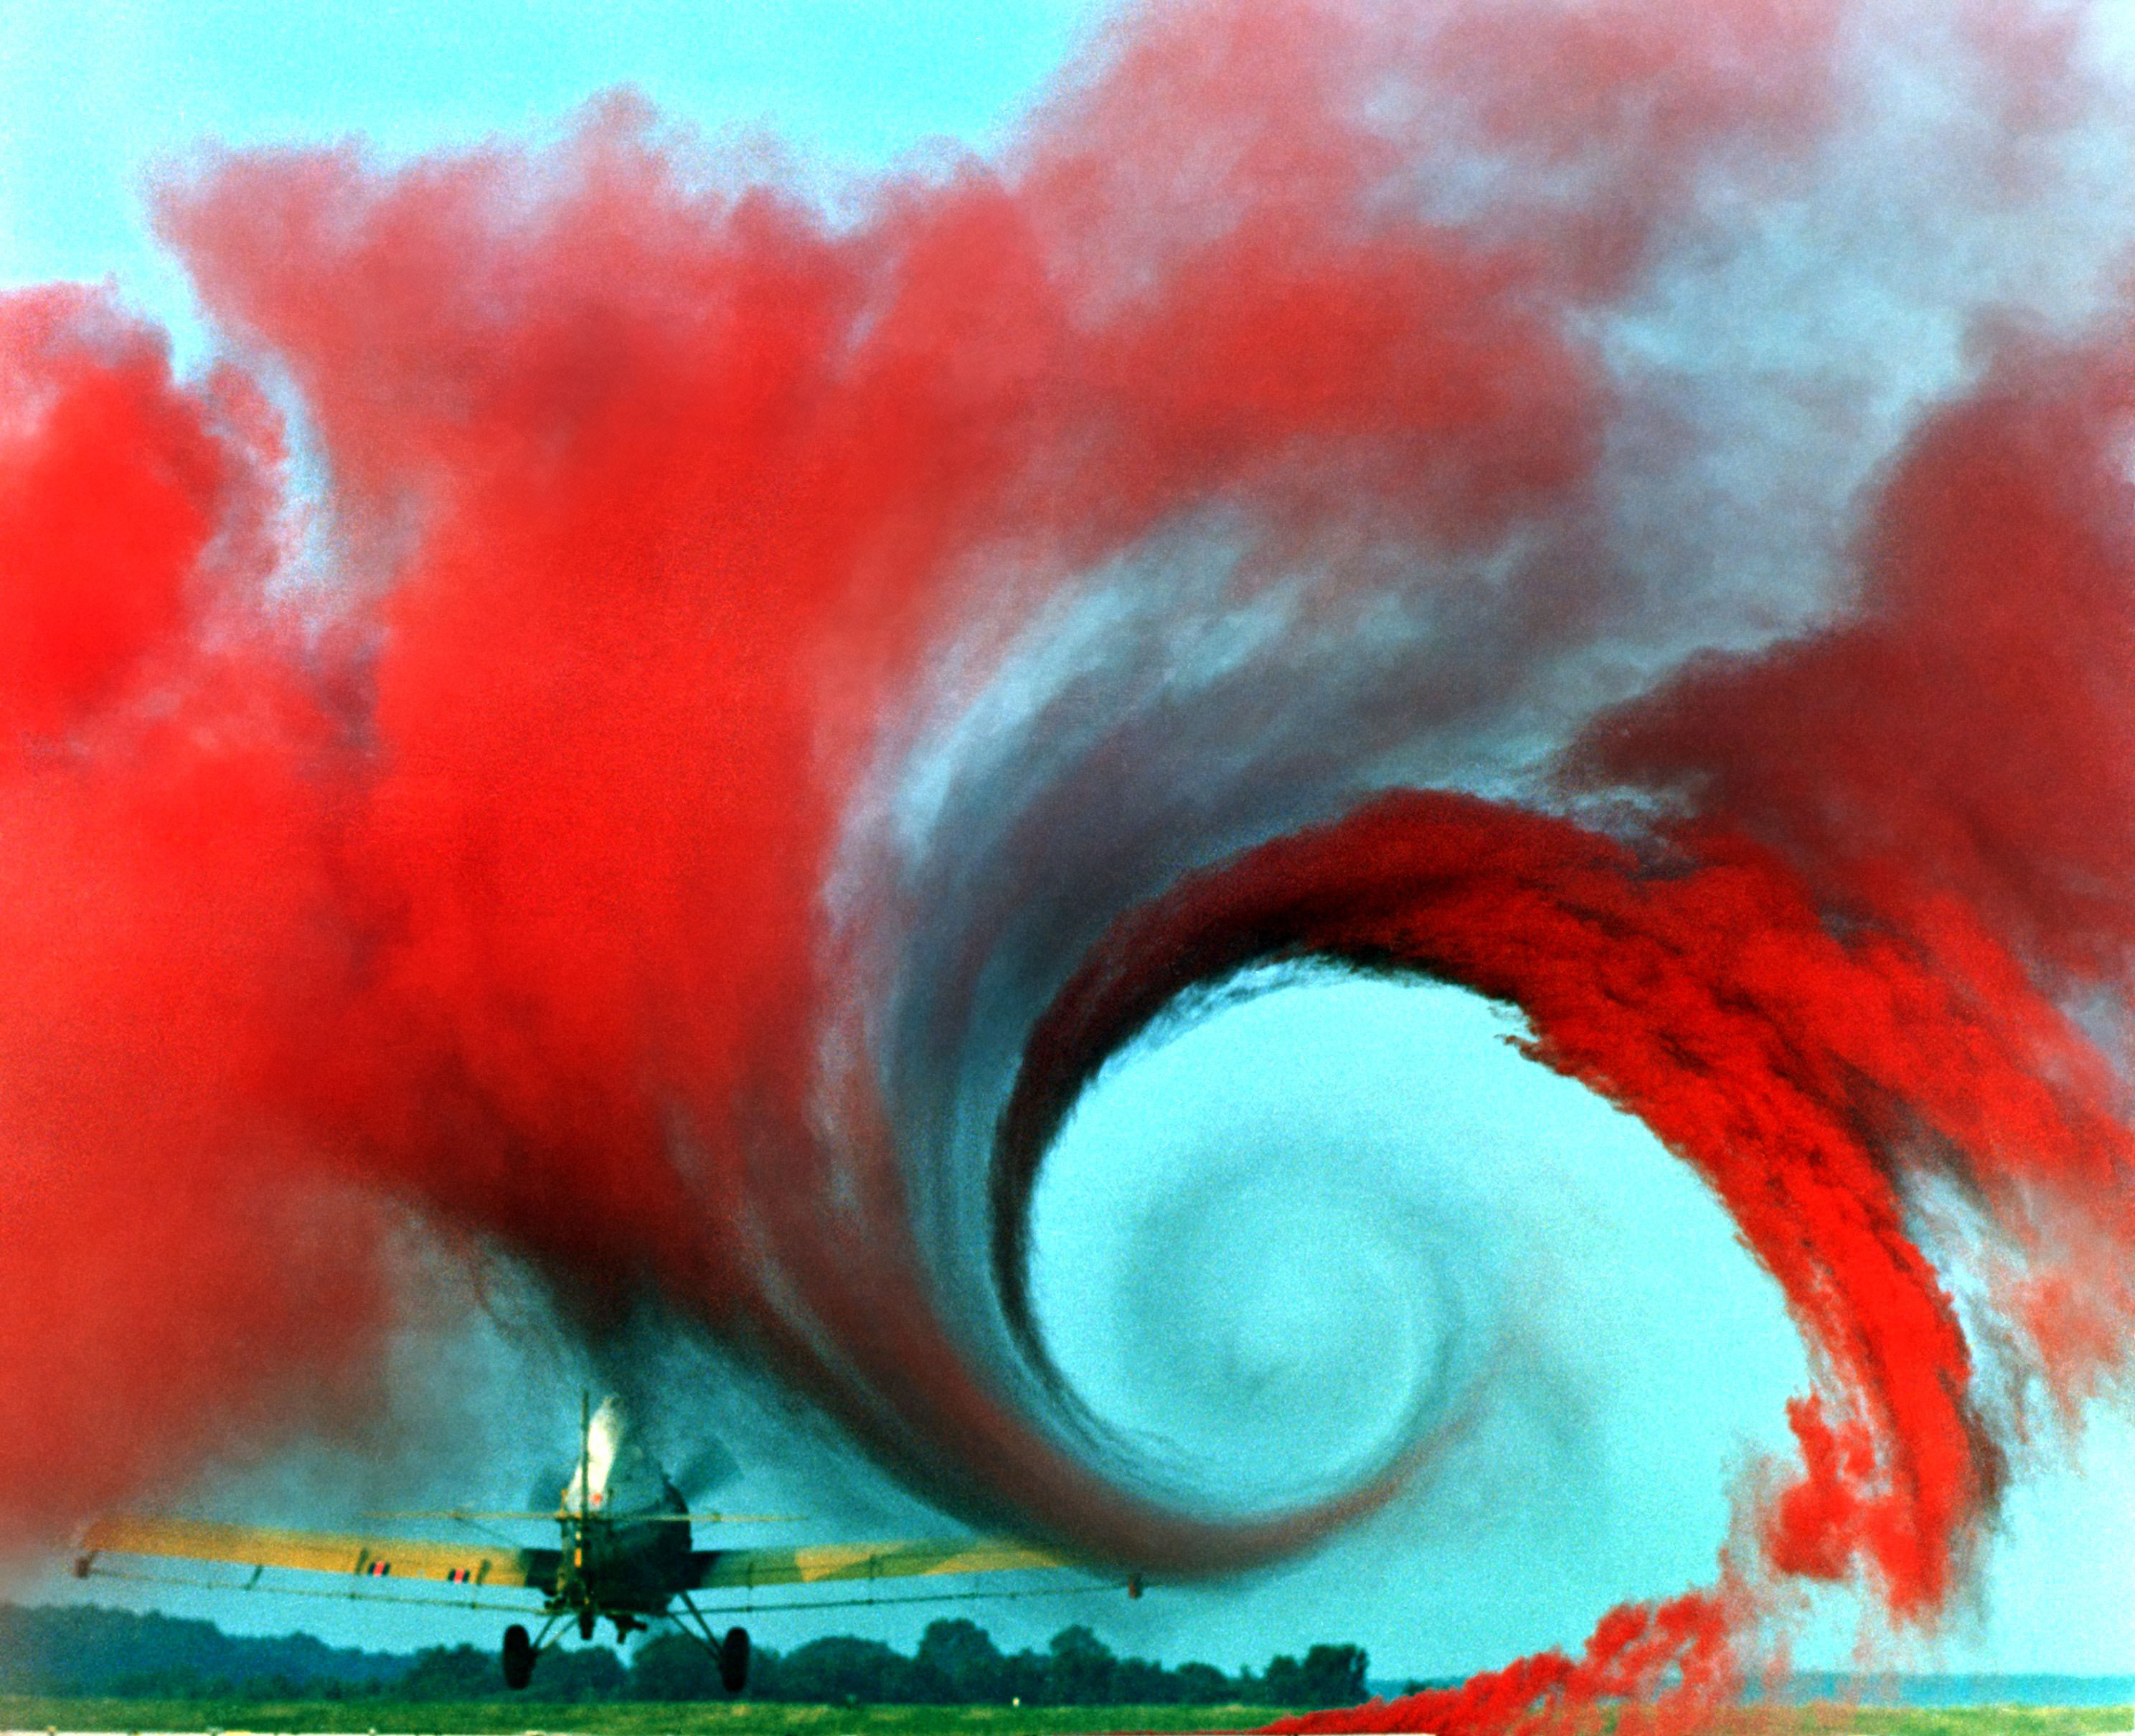
비행기 뒤에서 연기로 드러난 실제 공기 소용돌이

커피에 우유를 떨어뜨리고 저으면 가느다란 줄과 소용돌이가 생깁니다. 눈으로는 자연스럽게 보이지만, 모든 위치의 속도와 압력이 다음 순간 어떻게 변할지 수학으로 완전히 보장하는 일은 어렵습니다. Navier–Stokes 방정식은 시간에 따른 속도 변화, 흐름이 스스로를 옮기는 효과, 압력, 점성을 한 식에 담습니다.

방정식이 이미 있는데 무엇이 문제였을까?

계산 규칙을 아는 것과 모든 가능한 입력에서 문제가 생기지 않는다고 증명하는 것은 다릅니다. 날씨나 항공기 주변 공기를 컴퓨터로 계산할 수 있다는 사실만으로, 허용된 모든 3차원 흐름의 해가 영원히 매끄럽다고 결론 내릴 수는 없습니다.

방정식은 흐름을 쓰지만, 모든 해의 매끄러움까지 보장하지는 않습니다.

∂u/∂t + (u·∇)u = −∇p + νΔu + f

비압축 조건: ∇·u = 0

시간 변화
∂u/∂t
흐름의 자기 이동
(u·∇)u
압력의 밀기
−∇p
점성의 완화
νΔu
ν는 그리스 문자 뉴
바깥의 힘
f

정칙성 질문
3차원에서 유한 에너지 해가 항상 매끄러운가, 아니면 유한 시간에 특이점이 생길 수 있는가?

도식의 u는 속도장, p는 밀도로 나눈 압력, ν는 점성을 나타내는 그리스 문자 뉴(nu), f는 바깥에서 가하는 외력을 나타냅니다. 여기서 ν는 영어 소문자 v가 아닙니다. 첫째 줄은 흐름의 시간 변화와 자기 이동이 압력·점성·외력과 균형을 이루는 운동량 방정식입니다. 둘째 줄의 ∇·u = 0은 밀도가 일정한 비압축성 유체가 한 지점에서 갑자기 생기거나 사라지지 않는다는 제약입니다. 핵심 질문은 이 두 식을 만족하며 처음에 잘 정의된 흐름이 계속 매끄러운지, 아니면 어느 순간 속도 같은 값이 통제되지 않을 수 있는지입니다.

이번 발표가 말한 것은 무엇일까?

OpenAI는 정지 상태에서 시작한 유체에 특별히 설계한 매끄러운 외력을 가하면, 전체 운동에너지는 유한하지만 최대 속도는 유한 시간 안에 제한 없이 커지는 구성을 만들었다고 발표했습니다. 증명 원고와 Lean 형식화 코드도 함께 공개했습니다.

여기서 외력은 바깥에서 흐름을 미는 힘입니다. 모든 물이나 공기가 실제로 폭주한다는 뜻도 아니고, 실험에서 무한한 속도를 측정했다는 뜻도 아닙니다. Clay가 제시한 여러 해결 경로 가운데 외력이 있는 경우에 대한 수학적 주장입니다.

컴퓨터가 검사했으면 끝난 것 아닐까?

Lean은 논리 단계를 정해진 규칙으로 검사할 수 있게 돕습니다. 하지만 원래 문제의 조건과 컴퓨터에 입력한 정의가 같은지, 논문과 코드가 정확히 대응하는지는 독립 연구자가 다시 확인해야 합니다.

연구 주장 공개부터 형식 검증과 독립 검토, 공식 인정까지의 단계

따라서 현재 가장 정확한 표현은 “검증 가능한 증명 후보가 공개됐다”입니다. 회사 발표, 형식 검증 자료, 독립 검토, 학계의 일반적 수용과 공식 인정은 서로 다른 단계입니다.

가장 큰 한계

이 결과가 맞더라도 내일의 기상예보나 항공기 설계가 곧바로 좋아지는 것은 아닙니다. 새 계산 알고리즘이나 제품을 발표한 연구가 아니라, 방정식이 허용하는 해의 성질을 다루는 수학 연구이기 때문입니다. 앞으로는 독립 연구자들이 같은 증명과 형식화 코드를 검토하고, 원래 문제의 가정이 끝까지 유지되는지를 확인해야 합니다.

수식의 각 항, Clay의 A·B·C·D 해결 경로, 증명 구성과 검증 범위는 GitBlog 전체 해설에서 더 자세히 볼 수 있습니다.

공식 자료

위의 소용돌이 사진은 NASA 공개 자료를 바탕으로 한 Wikimedia Commons 파일이며, 두 도식은 JJo가 원문을 설명하기 위해 직접 제작했습니다. 실제 특이점의 측정 사진이나 논문 원본 Figure가 아닙니다.

라벨: , , ,

2026년 8월 29일 토요일

반도체 설계 AI

칩을 설계한다는 것은 무엇일까

스마트폰이나 AI 서버 안의 칩은 아주 많은 전자 스위치와 금속선을 한 장의 작은 판 위에 넣은 결과물이다. 먼저 설계자는 “이 칩이 무엇을 계산하고, 어떤 순서로 신호를 처리할지”를 코드와 도면으로 적는다. 그러나 그 초안은 아직 공장에서 만들 수 있는 칩이 아니다.

그다음에는 수많은 회로 블록을 어디에 놓을지 정하고, 서로 연결할 금속선을 그리며, 전기가 제시간에 도착하는지와 공장 규칙을 지키는지를 검사해야 한다. 이 긴 작업을 돕는 전문 소프트웨어가 **EDA(Electronic Design Automation)**다. AI는 이 과정을 통째로 대체하기보다, 사람이 고르기 어려운 수많은 설계 선택지에서 더 좋은 후보를 빠르게 찾아 주는 역할을 맡기 시작했다.

칩이 할 일 결정
  → 회로 초안 작성
  → 부품을 칩 위에 배치
  → 금속선으로 연결
  → 속도·전력·제조 가능성 검사
  → 실제 생산

AI는 설계 과정에서 무엇을 돕나

1. 너무 많은 선택지에서 후보를 찾아 준다

칩 안의 큰 부품을 어느 위치에 놓을지, 배선 도구의 설정을 어떻게 조절할지에 따라 결과가 달라진다. 한 가지 설정이 속도에는 좋아도 전력 소모나 칩 면적에는 나쁠 수 있다. 그래서 설계팀은 보통 더 빠르게, 전기를 덜 쓰게, 면적은 더 작게 만들 방법을 함께 찾는다. 이 세 가지를 묶어 PPA(Performance·Power·Area)라고 부른다.

AI는 수백~수천 가지 후보를 비교해 “다음에는 이 설정을 시험해 보자”고 제안한다. 좋은 답을 한 번에 알아맞히는 마법이 아니라, 결과를 보고 더 나은 다음 실험을 고르는 조수에 가깝다.

2. 사람이 읽기 어려운 설계 보고서를 읽게 돕는다

검사 뒤에는 “어느 구역의 배선이 너무 붐빈다”, “신호가 늦는다”, “금속선 간격이 공장 규칙보다 좁다” 같은 보고서가 나온다. AI agent는 이 보고서를 읽어 다음에 바꿔 볼 설정을 계획할 수 있다. 최근 OpenROAD MCP 같은 도구는 AI가 OpenROAD를 실행하고 보고서와 측정값을 다시 읽을 수 있게 연결한다.

다만 AI가 변경을 제안했다고 바로 생산하는 것은 아니다. EDA의 검사와 최종 signoff가 매번 “정말 만들 수 있는가”를 확인한다. AI는 조수이고, 검증 도구는 심사관이다.

3. 이전 실험을 다음 설계에 재사용할 수 있게 한다

어떤 AI는 한 설계에서 잘 작동한 배치 전략을 비슷한 다음 설계의 출발점으로 가져간다. 이를 전이학습이라고 한다. 예를 들어 이전 설계에서 배선이 덜 꼬였던 부품 배치의 감각을 새 설계의 첫 후보에 반영하는 식이다. 하지만 설계 크기, 제조 공정, 라이브러리가 달라지면 이전 경험이 그대로 통하지 않을 수도 있다. 그래서 새 설계에서도 실제 검사로 다시 확인해야 한다.

처음 읽는 사람을 위한 용어 사전
용어쉽게 말하면
RTL칩이 어떤 일을 할지 코드처럼 적은 초안
EDA초안을 실제 제조 가능한 칩 배치도로 바꾸고 검사하는 도구
PPA속도(Performance), 전력(Power), 면적(Area)의 균형
timing신호가 제시간에 도착하는지 검사하는 일
congestion배선이 한곳에 너무 몰려 막힌 상태
DRC선폭·간격 같은 공장 규칙 위반 검사
signoff생산 직전 ‘만들어도 된다’를 확인하는 최종 합격 판정

실제 사례로 보면 더 쉽다

Google AlphaChip: 큰 부품을 어디에 놓을지 배우는 AI

circuit_training은 큰 회로 블록을 칩의 어느 위치에 둘지 반복해서 배운다. 부품 위치가 좋으면 연결선이 짧아지고 배선이 덜 막힐 가능성이 있다. AI는 한 부품을 놓고 결과를 확인한 다음, 다음 부품의 위치를 고른다. 이를 reinforcement learning(RL)이라고 부른다.

Synopsys DSO.ai와 Cadence Cerebrus: 설계 도구의 설정을 탐색하는 AI

상용 도구는 보통 칩을 새로 발명하기보다, 기존 설계 도구가 가진 많은 설정을 더 효율적으로 탐색한다. Synopsys DSO.ai와 Cadence Cerebrus가 대표적이다. 설계자는 목표와 제약을 정하고, AI는 여러 후보를 실행·비교해 팀이 검토할 결과를 만든다.

OpenROAD: 직접 실험해 볼 수 있는 공개 도구

OpenROAD는 칩 설계의 많은 단계를 공개 도구로 실행할 수 있게 만든 프로젝트다. 여기에 AutoTuner를 붙이면 사람이 하나씩 설정을 바꾸지 않아도 여러 후보를 비교할 수 있다. OpenROAD MCP는 AI assistant가 이 도구의 실행 결과와 보고서를 읽도록 연결한다.

그럼 AI가 칩을 혼자 설계하는 시대인가

아직은 아니다. 현재 AI가 특히 잘하는 일은 반복 실험을 줄이고, 많은 후보 중에서 유망한 방향을 찾는 일이다. 반면 칩을 생산할 수 있는지의 최종 판단은 전기적 규칙, 물리 현상, 제조 규칙을 확인하는 결정론적 검증 도구가 맡는다.

이 차이를 알고 있으면 “AI가 반도체 설계를 했다”는 표현도 훨씬 정확하게 읽을 수 있다. 대개는 AI가 설계 과정의 한 부분—배치, 설정 탐색, 보고서 해석, 실험 계획—을 더 빠르게 돕고 있다는 뜻이다.

더 깊이 보기: 조사와 실험에 쓰는 지도

아래부터는 이 글을 조사·실험에 사용하려는 독자를 위한 상세 자료다. 처음 읽을 때는 건너뛰어도 된다.

AI가 ‘스스로 개선한다’는 말을 나누어 보는 기준

설정 변경 → EDA 실행 → 속도·전력·면적·규칙 위반 확인 → 다음 설정 변경이 설계 AI의 기본 고리다. 여기서 앞선 실험 결과로 다음 선택을 더 잘하면 adaptive optimization, 그 선택 규칙 자체를 보상으로 학습하면 RL, 다른 설계에 경험을 옮기면 transfer learning이라고 부른다.

단계조사용 이름뜻
0Automation정해진 script/flow를 실행한다.
1Parameter searchgrid/random으로 설정을 넓게 시험한다.
2Adaptive optimization이전 결과로 다음 후보를 더 유망하게 고른다.
3Reinforcement learning행동 결과의 보상으로 선택 규칙을 갱신한다.
4Transfer learning한 설계의 경험을 다음 설계의 출발점으로 가져간다.
5Continual learning여러 프로젝트의 경험을 장기적으로 보존·재사용한다.
6Agentic EDAagent가 계획하고 도구를 호출하고 보고서를 읽는다.
7Self-verifying agentic EDAagent의 행동을 EDA·물리 검증이 매번 통과/거부한다.
8Recursive improvement탐색 전략·목표·도구 순서까지 실험으로 개선한다.

이 표는 제품의 등급표가 아니다. 공개 근거가 어디까지 있는지 분리하기 위한 조사 틀이다. 특히 장기 기억과 재귀 개선은 공개적으로 검증된 일반 해법이라고 보기 어렵다.

어떤 방식으로 다음 후보를 고르는가

방법무엇을 배우나피드백표본 효율일반화EDA에 맞는 자리공개 구현
Grid / random학습 없음각 trial QoR낮음없음작은 knob sanity checkOpenROAD AutoTuner sweep
Bayesian optimization / Gaussian processobjective의 대리모형소수의 비싼 EDA trial높음feature 설계에 좌우flow tuning, HPOAx/Optuna 기반 AutoTuner
Evolutionary / genetic / CMA-ES후보 population·분포세대별 QoR중간약함~중간비미분·mixed discrete knobNevergrad, Optuna
Simulated annealing현재 해의 수용 확률objective 변화중간없음placement·combinatorial baselinecyclic RL+SA 연구
Contextual banditcontext별 action 가치빠른 보상높음context 품질에 좌우반복 recipe 선택BO+bandit search
RLpolicy/valuetrajectory reward보통 낮음pretrain 시 개선 가능placement, sequential optimizationcircuit_training
GNN + RLnetlist/graph 표현과 policyphysical QoR학습 비용 큼graph transfer 가능성macro placement, HLS DSEAlphaChip 계열 연구
Surrogate model빠른 QoR 예측기과거 EDA label매우 높음distribution shift 위험expensive run filterCircuitNet 기반 연구
Differentiable / gradient placement위치·density의 gradientanalytic surrogate높음tool/assumption 의존global placementDREAMPlace
Meta / transfer / continual learning초기화·policy·memory여러 design 결과장기적으로 잠재력 큼핵심 과제cross-design warm start연구 단계
LLM / multi-agent계획·tool sequence·설명report·tool outputtool 비용에 좌우prompt/tool schema 의존flow orchestrationOpenROAD MCP, vendor agents

중요한 구분: Gaussian process는 Bayesian optimization에서 자주 쓰는 surrogate이고, evolutionary algorithm·genetic algorithm·CMA-ES는 후보 분포를 진화시키는 서로 다른 계열이다. “AI”라는 한 단어로 묶으면 표본 효율, 실패 모드, 재현 비용이 사라진다.

대표 사례를 더 자세히 보기

AlphaChip / Google circuit_training — RL이 실제 배치를 어떻게 다루는가

circuit_training은 Google Research가 공개한 distributed deep RL 기반 chip floorplanning framework다. 큰 회로를 graph로 표현하고, macro를 어느 위치에 놓을지를 순차 action으로 선택한다. state에는 이미 배치된 macro와 연결 구조, action에는 다음 macro의 위치 후보, reward에는 wirelength·congestion·density 같은 물리 proxy가 들어간다. 좋은 proxy reward로 빠르게 후보를 거른 뒤 실제 physical implementation으로 평가한다.

이 구조에서 “학습이 더 좋아진다”는 뜻은 policy가 이전 placement trajectory의 reward를 사용해 다음 placement 선택을 갱신한다는 것이다(Level 3). 공개 저장소는 pretraining과 fine-tuning이 placement 속도·품질에 도움을 준다고 설명하므로, 다른 block으로 초기 policy를 옮기는 부분은 Level 4 주장에 해당한다. 다만 이는 저장소·저자 측 근거이며 모든 회사·PDK·block에서의 보편적 우월성을 뜻하지 않는다. Nature 논문에는 2024년 addendum도 있으므로, 결과를 인용할 때는 재현 조건과 평가 protocol을 함께 읽어야 한다. Nature 논문 · 공개 비판적 평가 · 2024 addendum

Synopsys DSO.ai — 상용 design-space optimization

DSO.ai는 reinforcement learning 기반으로 implementation flow의 넓은 설정 공간을 탐색한다고 설명한다. 즉 AI가 chip 자체를 직접 “발명”한다기보다 Fusion Compiler/IC Compiler II 같은 EDA flow의 선택지를 반복 평가하는 DSO 엔진에 가깝다. vendor는 상용 tapeout과 PPA 성과를 발표했지만, 특정 배수 개선·tapeout 수는 vendor/customer 발표라는 성격을 유지해야 한다. 독립 benchmark·동일 조건 재현 없이 일반 성능으로 확장하면 안 된다. Synopsys의 100 commercial tapeout 발표

Cadence Cerebrus — 탐색에서 agentic multi-block으로

Cerebrus는 2021년 Intelligent Chip Explorer에서 출발해 physical implementation 전반의 AI exploration을 내세웠고, 이후 AI Studio에서 subsystem·multi-block·multi-user·transfer를 강조한다. 이것은 Level 2–4의 DSE 위에 Level 6 성격의 orchestration을 얹는 방향이다. 그러나 장기 cross-project memory가 regression 없이 축적된다는 강한 독립 검증과, agent가 signoff 없이 판단해도 된다는 뜻은 아니다. Cadence multi-block white paper

Siemens Fuse / Solido — ‘self-verifying’이 의미 있는 이유

Siemens는 2026년 Fuse EDA AI Agent와 self-verifying architecture를 발표했다. 여기서 좋은 설계 원리는 LLM이 정답을 선언하지 않고, agent가 계획·실행한 매 step을 deterministic EDA engine 및 physics 기반 분석이 다시 검증한다는 것이다. 이것이 Level 7의 정의에 가장 가깝다. 다만 “every project에서 학습한다” 같은 표현은 vendor architecture/roadmap 주장으로 읽고, public benchmark와 모델 업데이트 범위를 따로 확인해야 한다.

OpenROAD: 누구나 재현할 수 있는 설계 실험

OpenROAD와 OpenROAD-flow-scripts (ORFS)는 RTL-to-GDSII 흐름을 공개한다. AutoTuner는 JSON으로 knob 범위를 정의하고 Ray Tune으로 grid/random, PBT, HyperOpt/TPE, AxSearch, Optuna+CMA-ES, Nevergrad evolutionary search를 고를 수 있다. PPA coefficient와 METRICS2.1 결과를 보상/목표로 쓰므로 Level 1–2의 좋은 기준선이다. RL이 아니어도 충분히 유용한 이유가 여기에 있다.

2026년 OpenROAD MCP는 AI client가 OpenROAD/ORFS session, command history, metrics, report image를 읽고 실행하도록 연결한다. 가능한 폐루프는 LLM agent → MCP → ORFS/OpenROAD → metrics·reports → analysis → revised config → re-run이다. 하지만 MCP는 도구 연결 규약일 뿐, 자동으로 학습·전이·안전을 보장하는 optimizer는 아니다. agent가 설정을 바꾸는 권한, command allowlist, experiment DB, deterministic signoff gate를 별도로 설계해야 Level 7에 가까워진다.

공개 생태계: AI 프로젝트와 재현 도구

아래는 연구·실험을 실제로 조립할 때 유용한 공개 프로젝트다. 첫 묶음은 직접적인 optimization/EDA ML/automation이고, 두 번째 묶음은 이를 평가·재현하기 위한 flow·PDK·검증 기반이다. 모두가 2024–26년에 새로 나온 “자율 설계 AI”라는 뜻은 아니다.

역할프로젝트왜 보는가
RL placementcircuit_trainingAlphaChip 계열 RL framework
RTL-to-GDSOpenROAD · ORFS공개 physical-design ground truth
tuningAutoTunerRay 기반 DSE baseline
agent tool bridgeOpenROAD MCPtool calls, metrics, reports
open flowLibreLane · OpenLanereproducible ASIC flow
differentiable placementDREAMPlace · AutoDMPGPU placement / design automation research
ML dataCircuitNetcongestion·DRC·IR-drop dataset
implementationiEDAopen EDA implementation
analog automationALIGNSPICE netlist to analog layout
architecture/RTLChipyard · OpenFASoCdesign generation/evaluation input
compiler/simulationYosys · Verilator · Cocotbsynthesis·simulation regression
FPGA / layoutnextpnr · VTR · Coriolisalternative CAD experiments
HDLs / generatorsAmaranth · Magma · PyMTL3 · LiteXparameterized design sources
PDK / reproducibilitySkyWater PDK · Hammer · Faultopen PDK·flow orchestration·test

이 directory는 최소 26개 project를 직접 연결한다. 연구를 시작할 때 “repo가 있다”와 “논문 결과를 재현했다”를 구분해야 한다. commit, version, PDK license, design input, seed, run log가 없으면 둘은 다르다.

설계 밖에서도 같은 일이 일어난다: 제조 AI

fab에서의 self-optimization은 설계와 다른 시간척도를 가진다.

equipment sensor → process measurement / metrology → AI model
→ recipe recommendation or bounded change → wafer processing
→ inspection · yield → model update

여기에는 서로 다른 다섯 일을 혼동하지 않는 것이 중요하다.

종류질문예
Adaptive process control / APC지금 공정 조건을 얼마나 보정할까?overlay·CD feedback
Virtual metrology매번 직접 재지 않고 값을 추정할 수 있나?sensor→film thickness estimate
Run-to-run control이전 wafer/lot 결과를 다음 recipe에 반영할까?drift correction
Predictive maintenance / anomaly장비가 나빠지기 전에 알 수 있나?chamber health, pump anomaly
Digital twin / autonomous process optimization안전 범위 안에서 recipe 자체를 탐색할까?bounded experiment + yield gate

ASML은 2025 annual report에서 computational lithography와 wafer metrology/inspection을 연결해 process window를 예측·제어하는 holistic lithography를 설명한다. Applied Materials의 AIx/ExtractAI, Lam의 Equipment Intelligence/Fabtex, KLA의 inspection·data analytics도 같은 넓은 방향에 놓인다. 하지만 이들은 대부분 고객 fab의 recipe·data·안전 제약 속에서 작동한다. “AI가 fab을 자율 운영한다”는 말보다 제한된 action space 안에서 측정·검사·수율이 validator가 되는 폐루프라고 쓰는 편이 정확하다. Lam Equipment Intelligence · KLA process control

조사용 성숙도 매트릭스

시스템AutomationAdaptiveRLTransferContinualAgenticSelf-verificationRecursive
Grid/script flowYESNONONONONOPARTIALNO
OpenROAD AutoTunerYESYESNONONONOPARTIALNO
AlphaChip 공개 frameworkYESYESYESPARTIALUNKNOWNNOPARTIALNO
Synopsys DSO.aiYESYESYESPARTIALUNKNOWNPARTIALPARTIALUNKNOWN
Cadence Cerebrus / AI StudioYESYESYESPARTIALUNKNOWNPARTIALPARTIALUNKNOWN
Siemens Fuse agent architectureYESPARTIALUNKNOWNUNKNOWNvendor claimYESYESUNKNOWN
OpenROAD MCP + agent (직접 구축)YES구축 방식에 따름구축 방식에 따름구축 방식에 따름구축 방식에 따름YES구축 방식에 따름NO 기본값
fab APC / process controlYESYES일부제한적제한적일부measurement gateNO 일반화

UNKNOWN은 실패를 뜻하지 않는다. 공개 자료만으로 업데이트 대상·retention·cross-project benchmark를 검증할 수 없다는 뜻이다. 특히 vendor 발표는 capability와 방향을 알려 주지만, 독립 성능 비교를 대체하지 않는다.

재현 가능한 실험 로드맵

가장 좋은 출발은 거대한 agent가 아니라, 실패해도 원인을 알 수 있는 작은 closed loop다.

단계구성목표 / metric위험연구 기여
1. BO/AutoTuner baselineRTL → Yosys → ORFS/OpenROAD → public PDK → Ray TunePPA, WNS, DRC, runtime, costsearch-space leakage, seed variance공개 가능한 기준선
2. RL optimizergraph/state, action mask, reward, replay, physical evalconstraint-satisfying Pareto QoRsparse reward, simulator/proxy gap, computepolicy가 baseline을 넘는지 검증
3. Agentic self-verifyingLLM agent → OpenROAD MCP → ORFS → experiment DB → signoff gatevalid action rate, recovery, regression-free QoRhallucinated command, unsafe mutation계획과 검증의 분리

Stage 1은 PDK·RTL·constraint·seed·trial budget을 고정하고 모든 log를 저장한다. Stage 2는 RL reward가 실제 signoff metric과 어긋나는지 확인한다. Stage 3은 agent가 결과를 “해석”해도 EDA signoff만이 실행 권한을 승인하게 한다. 필요한 compute, dataset, objective, metric, risk를 논문마다 표준화해 기록하면 어떤 성과가 알고리즘 덕분이고 어떤 성과가 benchmark 선택 덕분인지 보인다.

최소 experiment database 스키마

design_id, rtl_commit, pdk_version, flow_version, config, seed, action, metrics, constraint_status, reports, runtime, compute_cost, reviewer_decision을 trial마다 append-only로 남긴다. 이 데이터가 있어야 transfer/continual learning도 검증할 수 있다. memory가 있다는 말은 대화 기록을 저장했다는 뜻이 아니라, 새 design의 성능을 개선하면서 과거 design을 퇴행시키지 않았다는 측정까지 포함한다.

조사할 때 확인할 질문

앞으로 어떤 “AI가 반도체 설계를 스스로 개선했다”는 주장을 만나면 다음을 묻자.

  1. 개선된 것은 policy인가, hyperparameter인가, script인가, physical design인가, model weight인가, workflow인가, memory인가, recipe인가?
  2. feedback은 proxy인가, full EDA인가, deterministic signoff인가, 실제 wafer/yield인가?
  3. online인가 offline인가? action은 사람이 승인했는가?
  4. 한 benchmark만 좋아졌나, 새로운 design·block·PDK에도 일반화됐나?
  5. 지식이 남는가? catastrophic regression은 어떻게 측정했나?
  6. 어떤 validator가 잘못된 결정을 거부하나? timing·DRC·IR·EM·formal·physics 중 무엇인가?
  7. system이 스스로 바꾸는 범위는 후보 설정까지인가, search strategy·objective·tool sequence까지인가?

이 질문에 답하지 못하면 그 시스템은 훌륭한 자동화 또는 탐색 도구일 수는 있어도, 검증된 recursive self-improving design system이라고 부르기 어렵다. 반대로 이 질문에 답할 수 있는 폐루프를 만드는 것이 AI-for-EDA 연구의 가장 실용적인 다음 단계다.

공식 자료와 더 읽을 거리

자료 해석 원칙 — 논문·공식 GitHub·공식 문서가 1차 근거다. vendor 제품 페이지·보도자료는 기능과 vendor claim의 근거로 사용했고, 독립적으로 확인되지 않은 성능·전이·자율성은 일반 사실로 쓰지 않았다. 이 글은 투자 조언이나 tapeout 보증이 아니다.
라벨: , , ,

2026년 8월 28일 금요일

AI가 이제 실험실의 손을 얻었다 — Anthropic의 Model Hardware Standard(MHS)

영상을 보고 솔직히 조금 충격을 받았다. Claude가 글을 읽고 코드를 작성하는 모습은 이제 익숙하다. 그런데 이번에는 AI가 현미경, 액체 분주기, 로봇팔, 양자컴퓨터의 레이저 같은 실제 장비를 연결하고, 실험하고, 결과를 읽고, 다음 행동까지 바꾸고 있었다.

Anthropic이 2026년 8월 27일 공개한 Model Hardware Standard(MHS)는 새로운 로봇 모델이 아니다. 여러 제조사와 연구실의 장비를 AI 에이전트가 공통된 방식으로 찾고, 상태를 읽고, 정해진 범위 안에서 조작하게 만드는 하드웨어 연결 표준에 가깝다.

한 문장으로 보면
MHS는 AI에게 단순한 장비 제어 버튼만 주는 것이 아니라, 장비의 기능·현재 상태·사용법·안전 한계를 함께 알려주는 공통 설명서를 만들려는 시도다.

Anthropic 공식 영상

Anthropic 공식 영상: Model Hardware Standard — AI operating physical equipment

처음 읽는 사람을 위한 3분 요약

  • MHS는 AI가 실험실·공장의 여러 장비를 공통된 방식으로 제어하도록 만드는 표준이다.
  • 장비마다 다른 SDK, 프로그램, 파일 형식, GUI를 하나의 일관된 인터페이스로 감싼다.
  • AI는 장비 상태를 읽고, 작업 순서를 정하고, 결과에 따라 조건을 바꾸고, 일부 오류에서 복구할 수 있다.
  • 배운 절차를 결정론적인 코드로 저장하면, 이후에는 AI가 매 순간 판단하지 않아도 같은 작업을 반복할 수 있다.
  • 다만 아직 제한된 연구 프리뷰이며, 실제 물리 현상에 대한 AI의 이해와 안전성에는 분명한 한계가 있다.

왜 이런 표준이 필요한가

연구실이나 공장의 장비는 생각보다 서로 대화하지 못한다. 로봇팔은 전용 SDK를 쓰고, 카메라는 별도의 프로그램을 쓰며, 오래된 실험 장비는 Windows COM이나 특정 폴더에 파일을 넣는 방식으로만 움직이기도 한다. 심지어 화면의 버튼을 사람이 누르는 것 외에는 제어 방법이 없는 장비도 있다.

그래서 장비 세 대를 함께 움직이는 간단한 자동화도 쉽지 않다. 자동화 엔지니어가 각 장비의 설명서를 읽고, 서로 다른 명령을 연결하고, 상태 확인과 오류 처리를 새로 만들어야 한다. Anthropic은 이런 통합 작업이 보통 수주에서 수개월까지 걸릴 수 있다고 설명한다.

기존 방식

  • 장비마다 다른 명령과 프로그램
  • 장비별 연결 코드를 따로 제작
  • 사람이 모든 순서와 예외를 작성
  • 오류를 사람이 늦게 발견

MHS가 만들려는 방식

  • 공통된 상태와 작업 표현
  • 표준 드라이버를 통해 연결
  • AI가 상태를 읽고 순서를 조율
  • 실시간 감시와 제한된 자동 복구

MHS는 어떻게 작동하는가

구조를 아주 단순하게 줄이면 다음과 같다.

MHS의 한 번의 실험 흐름

  1. 사람이 목표를 설명한다.
  2. AI 에이전트가 작업 순서를 계획한다.
  3. MHS가 장비의 기능·상태·안전 조건을 전달한다.
  4. 장비 드라이버가 실제 명령으로 번역한다.
  5. 로봇팔·현미경·분주기·레이저가 정해진 범위 안에서 동작한다.
  6. 센서와 장비 상태가 다시 AI에게 돌아가 다음 판단에 쓰인다.

1. 장비마다 MHS 드라이버를 만든다

MHS 드라이버는 서로 다른 장비의 복잡한 명령을 비교적 단순한 형태로 바꾼다. 예를 들어 온도를 읽거나, 목표 온도를 설정하거나, 로봇팔로 플레이트를 옮기는 동작을 공통된 방식으로 표현한다.

2. AI가 장비의 설명서를 함께 읽는다

중요한 것은 명령 이름만 제공하지 않는다는 점이다. 장비가 무엇을 측정할 수 있는지, 무엇을 바꿀 수 있는지, 현재 어떤 상태인지, 무게나 물리적 특성이 무엇인지, 어느 범위를 넘어가면 안 되는지까지 하나의 장비 설명 파일에 담는다.

그동안 종이 설명서나 숙련자의 머릿속에만 있던 정보도 자연어 태그로 기록할 수 있다. AI는 이 정보를 바탕으로 처음 보는 장비의 사용법을 이해한다.

3. AI는 MCP, 명령줄, 코드로 장비를 사용한다

MHS는 MCP(Model Context Protocol), 명령줄 인터페이스, 코드 API를 통해 접근할 수 있다. MCP가 AI를 소프트웨어와 데이터에 연결하는 공통 통로라면, MHS는 그 생각을 실제 물리 장비까지 확장한 형태로 볼 수 있다.

4. 반복 작업은 코드로 굳힌다

AI가 매 순간 온라인으로 생각하면서 장비를 움직일 필요는 없다. Claude가 여러 번 실험해 효과적인 방법을 찾으면, 그 과정을 검사 가능한 결정론적 스크립트로 작성할 수 있다. 이후에는 한 번의 명령으로 같은 절차를 빠르고 반복 가능하게 실행한다.

여기서 중요한 구분
MHS의 핵심은 LLM이 로봇 모터나 레이저의 초고속 제어 루프를 직접 돌리는 것이 아니다. AI는 위에서 실험을 설계하고, 상태를 분석하고, 절차를 개선한다. 빠른 제어와 비상정지는 기존 제어기와 하드웨어 계층이 맡는다.

무엇이 그렇게 충격적이었나

지금까지 생성형 AI는 주로 이미 존재하는 데이터를 읽었다. 문서, 코드, 이미지, 논문을 바탕으로 답을 만들었다. MHS가 보여준 다음 단계는 다르다.

가설장비 동작새 측정 데이터결과 평가조건 수정다시 실험

즉 AI가 인터넷에 있는 지식만 소비하는 것이 아니라, 현실 세계에서 새로운 데이터를 직접 만들어 다음 판단에 사용할 수 있는 순환 구조가 생긴다. 이 과정이 밤새 반복되면, 사람이 일일이 시험하기 어려운 수백·수천 개의 조건도 탐색할 수 있다.

개인적으로 가장 큰 충격은 로봇팔 하나를 움직였다는 사실이 아니었다. 이미 로봇 제어 API는 오래전부터 존재했다. 진짜 변화는 AI가 여러 장비를 하나의 실험 시스템으로 이해하고, 결과를 본 뒤 다음 실험을 스스로 수정했다는 점이다.

실제로 무엇을 했는가

Genentech — 단백질 실험 조건을 직접 최적화

Genentech는 액체 분주기, 로봇팔, 마이크로플레이트 리더를 연결해 단백질 농도를 측정하는 BCA assay를 자동화했다. Claude는 물과 점성이 높은 단백질 용액이 같은 속도로 분주되면 안 된다는 점을 실험으로 찾아냈다.

물에는 약 140 µL/s, 점성이 높은 BSA 용액에는 약 10 µL/s가 적절하다고 판단했다. 사람이 각 조건을 하나씩 프로그램하는 대신, AI가 시험하고 결과를 비교하며 조건을 좁혀간 것이다.

하지만 한계도 분명했다. 거품 때문에 오류가 발생했을 때 Claude는 처음에 같은 용기에서 조건만 바꾸며 재시도했고, 오히려 거품을 더 만들었다. 사람 전문가가 “소프트웨어 문제가 아니라 실제 액체의 물리 문제”라고 알려준 뒤에야 깨끗한 위치로 옮기는 해결책을 유지했다.

이 사례는 MHS의 가능성과 현재 AI의 약점을 동시에 보여준다. AI는 빠르게 조건을 탐색하지만, 현실의 재료·접촉·유체 현상을 항상 제대로 이해하는 것은 아니다.

Carnegie Mellon University — 서로 다른 장비를 약 8시간 만에 연결

Carnegie Mellon University 연구팀은 액체 분주기, 플레이트 리더, 로봇팔, 감시 카메라를 세 대의 컴퓨터에 나눠 연결했다. 문제는 장비마다 제어 방식이 완전히 달랐다는 것이다. 하나는 폴더에 작업 파일을 넣어야 했고, 하나는 오래된 Windows COM을 썼으며, 플레이트 리더는 정상적인 API조차 없었다.

연구팀은 MHS 드라이버와 전체 조율 계층을 약 8시간 만에 만들었다고 보고했다. 기존 공급업체 방식으로는 수주가 걸릴 수 있는 작업이었다. 실험 수행 속도도 이전보다 약 세 배 빨라졌다.

연구팀은 플레이트 누락, 방향 오류, 장비 사용 중, 카메라 연결 해제, 접근 불가능한 장비, 비상정지 활성화라는 여섯 조건을 일부러 만들었다. 시스템은 장비가 움직이기 전에 여섯 가지를 모두 차단했다.

첫 번째 농도-반응 실험의 결과가 좋지 않자 AI는 최고 농도를 200 µg/mL에서 100 µg/mL로 낮추고 새 플레이트로 다시 실험했다. 두 번째 결과는 훨씬 나은 적합도를 보였다. 사람이 결과를 보고 다음 조건을 정하는 과정까지 에이전트가 연결한 것이다.

QuEra — 양자컴퓨터 레이저 복구 성공률 99.3%

가장 인상적인 사례는 양자컴퓨터 기업 QuEra의 레이저 시스템이다. 양자컴퓨터의 레이저는 온도, 진동, 압력 변화 때문에 매우 정밀한 목표 주파수에서 벗어날 수 있다. 기존 자동 복구 스크립트는 성공률이 약 58%였고, 한 번 복구하는 데 약 150초가 걸렸다. 사람 전문가가 직접 복구하면 보통 5~10분이 필요했다.

Claude는 MHS를 통해 실제 테스트 장비를 읽고 조절하면서 복구 방식을 반복적으로 개선했다. 가설을 만들고, 코드를 수정하고, 실제 레이저에서 시험하고, 로그를 읽는 과정이 밤새 수백 번 반복됐다.

최종 검증에서는 700회 중 695회 복구에 성공해 99.3%의 성공률을 기록했다. 비교적 단순한 문제는 약 0.9~5.4초, 가장 어려운 문제는 약 10~14초 만에 복구했다.

더 중요한 사실은 최종 운용 단계에서 Claude가 매번 레이저를 직접 조작하지 않았다는 점이다. Claude가 개발하고 검증한 결과는 완전히 검사 가능한 결정론적 프로그램으로 남았고, 실제 장비에서는 AI가 빠진 상태로 실행됐다.

AI가 한 일: 더 나은 제어 절차를 발견하고 코드로 만들었다.
실제 운용에서 한 일: 검증된 코드가 정해진 범위 안에서 장비를 제어했다.

MCP와 무엇이 다른가

Anthropic은 2024년 MCP를 공개하며 AI가 파일, 데이터베이스, 개발 도구, 업무 시스템에 연결되는 방식을 표준화하려 했다. MHS는 그 방향을 물리 세계로 확장한다.

  • MCP: AI와 소프트웨어·데이터·도구를 연결한다.
  • MHS: AI와 실제 장비를 연결하고, 장비의 상태·기능·물리 정보·안전 한계를 전달한다.

USB에 비유하면 조금 이해하기 쉽다. USB는 서로 다른 장치를 컴퓨터에 연결하는 공통 규격이다. MHS는 여기에 “이 장비가 무엇을 할 수 있는지, 현재 어떤 상태인지, 어느 범위까지 허용되는지”를 AI가 이해할 수 있는 설명서까지 붙이려는 시도에 가깝다.

로봇 분야의 ROS 2나 산업 장비의 기존 통신 표준을 모두 없애려는 것으로 보이지는 않는다. 현재 공개된 설명만 보면 MHS는 그런 저수준 통신과 제어 기술 위에서, AI 에이전트가 장비를 발견하고 조합하기 쉽게 만드는 상위 계층에 가깝다.

왜 단순한 연구실 데모로 끝나지 않을 수 있나

초기 실험에는 HHMI Janelia, Genentech, University of Washington, Carnegie Mellon University, QuEra, Tetsuwan Scientific 등이 참여했다. 여기에 Doosan Robotics가 로봇팔 적용을 시험하고 있고, Universal Robots도 자사 로봇 플랫폼에 대한 지원 계획을 밝혔다. Hugging Face는 LeRobot에, Raspberry Pi는 여러 제품에 MHS 통합을 추진하고 있다.

이 참여 목록이 중요한 이유는 MHS가 특정 연구실의 맞춤형 코드로 끝나지 않고, 여러 장비 회사와 연구기관이 함께 쓰는 공통 규격을 목표로 하기 때문이다. 표준은 기술 자체보다 “얼마나 많은 장비와 사람이 함께 채택하느냐”가 더 중요하다.

하지만 아직 과장해서 보면 안 된다

MHS는 2026년 8월 기준으로 완성된 공개 표준이 아니라 제한된 연구 프리뷰다. Anthropic은 일부 파트너와 먼저 시험하고 안전 평가와 모범 사례를 만든 뒤 오픈소스로 공개할 계획이라고 밝혔다.

현재 공개 자료에서 확인되는 한계는 분명하다.

  • 프로그래밍 가능한 인터페이스가 없는 장비에는 아직 바로 적용하기 어렵다.
  • AI는 물리적·공간적 원인을 잘못 해석할 수 있어 전문가 감독이 필요하다.
  • 장비 설명과 안전 한계를 잘못 입력하면 표준만으로 안전을 보장할 수 없다.
  • 연구실의 성공 사례가 모든 공장과 모든 로봇 환경에서 그대로 재현된다는 보장은 없다.
  • ‘안전하게 동작한다’는 표현을 곧바로 산업용 기능안전 인증과 같은 의미로 받아들이면 안 된다.

결국 중요한 원칙은 AI의 판단과 실제 안전 기능을 분리하는 것이다. 허용 범위, 인터록, 비상정지, 충돌 방지처럼 즉시 작동해야 하는 기능은 모델의 말이 아니라 별도의 검증된 제어 계층에서 강제되어야 한다.

내가 이 발표를 중요하게 본 이유

이 발표는 화려한 휴머노이드 영상처럼 보이지 않을 수 있다. MHS 자체도 새로운 거대 AI 모델이나 새로운 로봇 하드웨어가 아니다. 하지만 오히려 그래서 중요하다.

AI가 현실 세계에서 일하려면 뛰어난 두뇌만으로는 부족하다. 수많은 장비를 연결하고, 현재 상태를 정확히 읽고, 허용된 행동만 실행하고, 실패를 기록하고, 결과를 다시 판단에 넣는 기반 구조가 필요하다. MHS는 바로 그 지루하지만 결정적인 연결 계층을 표준으로 만들려 한다.

MCP가 AI 에이전트를 디지털 도구와 연결하는 하나의 전환점이었다면, MHS는 AI가 실험실과 공장으로 나가기 위한 비슷한 전환점이 될 가능성이 있다. 물론 아직은 가능성을 보여준 초기 단계다. 그래도 방향은 분명해 보인다.

이 발표가 보여준 변화

AI가 지식을 설명하는 단계에서,
현실을 측정하고 바꾸고,
그 결과로 다시 배우는 단계로 이동하고 있다.

결론

Model Hardware Standard의 본질은 “Claude가 로봇팔을 움직였다”는 한 장면이 아니다. 핵심은 서로 다른 장비를 공통된 방식으로 연결하고, AI가 장비의 상태와 안전 조건을 이해하며, 여러 실험을 하나의 폐루프(closed loop)로 묶을 수 있게 만들려는 시도다.

아직은 연구 프리뷰이고 해결해야 할 안전·신뢰성 문제가 많다. 그럼에도 AI가 기존 데이터를 읽는 도구에서 벗어나, 실제 장비를 통해 새로운 데이터를 만들고 다음 실험을 설계하기 시작했다는 점은 상당히 큰 변화다.

영상을 보고 충격을 받은 이유도 바로 여기에 있다. AI가 컴퓨터 화면 안에서 더 똑똑해진 정도가 아니라, 현실 세계와 연결되는 공통 손과 감각을 만들기 시작했기 때문이다.


공식 자료와 더 보기

작성 기준: 2026년 8월 28일 · 이 글은 Anthropic과 참여 기관이 공개한 연구 프리뷰 자료를 쉽게 풀어쓴 해설이다.

라벨: , , , , , , ,

2026년 8월 27일 목요일

Venture Global (VG) 종합 투자보고서 — LNG 공급 사이클과 2026년 핵심 체크포인트

JJo Research Archive

이 글은 빠르게 읽는 요약본입니다. 표·공식 출처·세부 계산은 GitHub Pages의 Venture Global 전체 보고서 원문 ↗에서 이어서 볼 수 있습니다.

Venture Global · 프로젝트가 현금흐름으로 전환되는 순서 Calcasieu Pass운영·현금흐름 기반 Plaqueminesramp-up·마진 검증 CP2미래 NPV·실행 리스크
자체 제작 구조도 — 이 글의 핵심은 LNG 가격 하나가 아니라 세 프로젝트의 운영 전환 속도입니다.

처음 읽는 사람을 위한 3분 요약

LNG는 천연가스를 아주 낮은 온도로 액체처럼 만들어 배에 싣는 방식입니다. 미국에서 만든 가스를 유럽·아시아로 보내려면 이 과정이 필요합니다.

ramp-up은 공장을 켠 첫날부터 최대 생산량이 나오는 것이 아니라, 설비를 시험하고 안정화하며 생산량을 단계적으로 올리는 기간입니다. Plaquemines가 이 글에서 중요한 이유입니다.

SPA는 장기 판매계약입니다. 누가 몇 년 동안 어느 정도의 물량을 살지 미리 정해 두는 계약이라, 프로젝트 자금조달과 미래 매출의 가시성을 높여 줍니다.

한 문장으로 보면: 매 분기 Plaquemines가 더 많은 LNG를 안정적으로 내보내고, 그 결과 매출·EBITDA·현금흐름으로 이어지는지가 가장 먼저 확인할 질문입니다. 그 다음은 CP2의 일정입니다.

작성 기준: 2026년 3월

이 글은 특정 종목의 매수·매도 추천이 아니다. Venture Global(VG)을 단순 실적 숫자가 아니라 미국 LNG 공급 확대, 프로젝트 ramp-up, 장기 계약, 글로벌 가스 가격 스프레드라는 산업 구조 속에서 이해하기 위한 투자 분석 기록이다.

한눈에 보는 결론

Venture Global은 미국 LNG 공급 확대의 핵심 플레이어 중 하나다.

투자 포인트는 단순히 “LNG 가격이 오른다”가 아니다. 핵심은 다음 프로젝트가 순차적으로 현금흐름으로 전환되는지다.

Calcasieu Pass → Plaquemines LNG → CP2 LNG

단기적으로는 Plaquemines ramp-up과 2026년 EBITDA·Revenue 변동성이 중요하고, 중기적으로는 미국과 카타르의 대규모 공급 확대 속에서 VG가 얼마나 빠르게 신규 capacity를 commercial operation으로 전환하느냐가 중요하다.

장기적으로는 계약 구조, 원가 경쟁력, 자금조달 능력, 규제 및 메탄 대응이 valuation을 좌우한다.

회사와 핵심 자산

Venture Global은 미국 Gulf Coast를 기반으로 LNG liquefaction 및 export 사업을 하는 기업이다.

핵심 자산은 크게 세 개다.

운영 중

Calcasieu Pass

이미 가동 중인 첫 현금흐름 자산입니다.

지금 볼 것: 판매 물량과 기존 계약 매출이 안정적인지

순차 가동 중

Plaquemines LNG

설비를 한 번에 최대치로 켜는 것이 아니라, 단계적으로 생산량과 안정성을 끌어올리는 구간입니다.

지금 볼 것: 가동 진척, 출하량, 분기 실적 반영 속도

다음 성장 단계

CP2 LNG

아직 미래의 성장 프로젝트입니다. 오늘의 이익보다 허가·자금조달·건설 일정이 더 중요합니다.

지금 볼 것: 일정이 미뤄지지 않는지와 계약 확보 여부

VG를 볼 때 중요한 것은 단일 LNG 터미널 기업이 아니라 여러 프로젝트를 순차적으로 개발해 대형 LNG 플랫폼으로 확장하는 회사라는 점이다.

왜 시장이 주목하는가

핵심 이유는 네 가지다.

  • 미국 LNG 증설 wave의 중심에 있다.
  • 프로젝트 capacity가 빠르게 커지고 있다.
  • 장기 SPA와 상대적으로 유연한 물량이 동시에 존재한다.
  • Plaquemines와 CP2가 계획대로 진행되면 기업의 earnings power 자체가 크게 바뀔 수 있다.

따라서 VG의 valuation은 현재 실적만으로 설명하기 어렵고, project completion probability × future capacity × contract economics를 함께 봐야 한다.

LNG 시장은 어떤 국면인가

LNG 시장은 두 가지 힘이 동시에 작용한다.

  • 중기: 미국과 카타르를 중심으로 공급 capacity가 크게 늘어나는 방향
  • 단기: 날씨, 지정학, 저장 수준, 운송 병목 때문에 spot market이 급격하게 타이트해질 수 있음

이 구조 때문에 VG는 한편으로는 단기 가격 민감주, 다른 한편으로는 중기 공급 사이클주다.

2026년 이후 공급 사이클

2026 — 신규 LNG supply wave가 시작되는 구간이다. 하지만 지정학적 공급 차질이나 운송 문제 때문에 단기적으로는 오히려 시장이 타이트해질 수도 있다.

2027~2028 — 미국과 카타르의 신규 capacity가 본격적으로 시장에 들어오는 구간이다. 이 시기에는 spot LNG 가격 자체보다 어떤 프로젝트가 낮은 원가로 계약 물량을 안정적으로 공급할 수 있는지가 더 중요해질 가능성이 크다.

2030 이후 — 공급 capacity의 양보다 계약 구조, feed gas cost, liquefaction efficiency, shipping economics 등 자산의 질이 valuation 차이를 만들 가능성이 커진다.

VG에 중요한 수요처

유럽

유럽은 장기적으로 천연가스 수요가 감소할 수 있지만, 겨울 기온과 저장 수준에 따라 LNG 수입량이 크게 흔들린다.

VG 입장에서는 유럽이 영구적인 고성장 시장이라기보다 시장 수급이 타이트할 때 추가 물량을 흡수하는 방어적 outlet 역할을 할 수 있다.

아시아

장기 성장 측면에서는 아시아가 더 중요하다.

특히 한국, 일본, 중국과 가격 민감도가 높은 신흥국의 LNG demand가 중요하다.

미국 LNG는 아시아향 운송 거리가 길다는 단점이 있지만, 국제 LNG 가격이 충분히 높으면 destination economics가 크게 좋아질 수 있다.

결국 VG는 단순 판매 volume만 보는 것이 아니라 cargo가 어디로 가는지까지 봐야 한다.

오늘 현재 상태를 확인하는 순서

  1. 미국 가스 가격: 실제 현물 가격은 EIA Henry Hub 일별 가격 ↗, 시장의 미래 기대는 CME Henry Hub 선물 ↗에서 확인합니다.
  2. 해외 판매시장 가격: 동북아 기준은 CME JKM 선물 ↗, 유럽 기준은 ICE Dutch TTF 선물 ↗에서 봅니다.
  3. 미국 LNG가 실제로 얼마나 나가는지: EIA 미국 천연가스 수출 통계 ↗에서 월별 수출 흐름을 확인합니다.
  4. 회사가 계획대로 실행하는지: Venture Global 분기 실적·투자자 자료 ↗와 아래의 공식 발표에서 가동, 출하, EBITDA, 자금조달을 함께 확인합니다.

읽는 법: Henry Hub는 미국 원료가스 비용의 기준이고, JKM·TTF는 판매시장 가격의 참고점입니다. 다만 서로 단위와 계약 조건이 달라 숫자만 빼서 ‘마진’이라고 보면 안 됩니다. 방향을 먼저 보고, 실제 수익성은 회사의 분기 실적에 나온 매출·EBITDA·현금흐름으로 확인하는 편이 안전합니다.

가격: HH·TTF·JKM 스프레드

미국 LNG exporter를 분석할 때 기본적인 가격축은 세 개다.

  • Henry Hub (HH) — 미국 feed gas 가격
  • TTF — 유럽 가스/LNG 시장 가격의 핵심 proxy
  • JKM — 동북아시아 LNG 가격 benchmark

하지만 절대 가격보다 더 중요한 것은 spread다.

국제 LNG 가격 - 미국 천연가스 가격 - 액화 비용 - 운송비 - 기타 비용 = LNG export economics

Henry Hub가 낮고 TTF/JKM이 높다면 미국 LNG의 경제성이 좋아진다.

반대로 Henry Hub가 급등하거나 shipping cost가 크게 상승하면 국제 가격이 높아도 margin 개선폭이 줄어든다.

Plaquemines: 현재 실적의 핵심

현재 VG 투자 thesis에서 가장 중요한 프로젝트 중 하나가 Plaquemines LNG다.

대형 LNG project의 실적은 시설이 완성됐다는 뉴스 한 번으로 바로 정상화되지 않는다.

Mechanical completion → Commissioning → First LNG / first cargo → Train별 ramp-up → Reliability improvement → Commercial operation → 정상 utilization

이 전환 과정에서 volume과 margin이 크게 변할 수 있다.

따라서 Plaquemines 분석에서는 단순 “가동했다”가 아니라 다음을 봐야 한다.

  • 실제 cargo export가 얼마나 늘어나는가
  • train별 commissioning 속도
  • 가동률(utilization)
  • maintenance 및 outage
  • commissioning cargo와 contracted cargo 비중
  • commercial operation 전환 시점

CP2: 미래 가치의 핵심

CP2는 현재 실적이 아니라 미래 earnings capacity를 결정하는 프로젝트다.

Permit → FID → Financing → Construction → Commercial operation

프로젝트가 다음 단계로 넘어갈수록 미래 cash flow의 확률이 높아지고 valuation discount가 감소할 수 있다.

반대로 permitting, financing, construction cost가 예상보다 악화되면 장기 upside가 훼손된다.

장기 SPA와 계약 구조

LNG 사업은 장기 계약이 매우 중요하다.

장기 SPA는 일반적으로 다음 기능을 한다.

  • 미래 판매 volume 확보
  • 프로젝트 financing 안정성 향상
  • cash flow visibility 확대
  • spot price 변동성 완화

하지만 장기 계약이 많다고 무조건 좋은 것은 아니다. 계약 가격 구조와 destination flexibility를 같이 봐야 한다.

VG 같은 LNG exporter는 contracted volume과 flexible/merchant volume의 조합이 중요하다.

spot market이 강할 때 flexible cargo가 upside를 만들 수 있지만, 반대로 spot market이 약해지면 volatility가 커질 수 있다.

미국 LNG의 구조적 경쟁력

미국 LNG의 가장 큰 특징 중 하나는 Henry Hub 기반 feed gas다.

미국의 풍부한 shale gas supply 때문에 feed gas cost가 국제 LNG 가격과 분리될 수 있다.

HH 낮음 + TTF / JKM 높음 + shipping 정상 = export margin 개선

하지만 다음 변수들은 리스크다.

  • 미국 gas production 감소
  • pipeline bottleneck
  • LNG terminal feed gas competition
  • hurricane
  • shipping cost 상승
  • Panama Canal / Suez 등 운송 제약

핵심 투자 체크포인트

1. Plaquemines ramp-up

가장 먼저 볼 것은 실제 export volume이 계획대로 늘어나는지다.

2. EBITDA conversion

매출이 늘어나는 것보다 프로젝트 ramp-up이 EBITDA와 free cash flow로 얼마나 전환되는지가 중요하다.

3. Henry Hub vs TTF/JKM spread

국제 LNG 가격 상승만 볼 것이 아니라 미국 feed gas와의 spread를 같이 봐야 한다.

4. 장기 계약 book

추가 SPA가 future capacity를 얼마나 de-risk하는지 확인한다.

5. CP2 execution

FID, financing, construction, schedule delay 여부를 계속 봐야 한다.

6. Debt와 project financing

LNG는 매우 자본집약적인 산업이다. 성장 속도가 빠를수록 leverage와 financing cost가 중요한 변수가 된다.

밸류에이션: 단일 PER로 보기 어려운 이유

VG처럼 대형 프로젝트가 계속 올라오는 기업은 현재 PER 하나로 valuation하기 어렵다.

보다 적절한 접근은 다음과 같다.

Current operating assets value + Plaquemines normalized earnings value + CP2 risk-adjusted NPV - Net debt - Execution / regulatory discount

즉 현재 숫자와 미래 project value를 분리해 봐야 한다.

Bull case

  • Plaquemines ramp-up이 예상보다 빠름
  • utilization이 안정적으로 올라감
  • 국제 LNG와 Henry Hub spread가 강함
  • 추가 SPA로 CP2가 de-risk됨
  • financing 조건이 안정적임
  • 미국 LNG의 글로벌 market share가 확대됨

이 경우 VG는 단순 LNG 개발사가 아니라 대형 미국 LNG platform으로 재평가될 수 있다.

Bear case

  • Plaquemines commissioning 지연
  • project cost overrun
  • Henry Hub 상승
  • 글로벌 LNG 공급 과잉
  • TTF/JKM 하락
  • shipping bottleneck
  • CP2 일정 지연
  • regulatory risk
  • 높은 leverage

특히 LNG supply wave가 예상보다 빠르게 현실화되면서 spot spread가 축소되면 merchant/flexible volume의 가치가 감소할 수 있다.

결론

Venture Global을 볼 때 가장 중요한 질문은 “LNG 가격이 오를까?” 하나가 아니다.

더 중요한 질문은 다음과 같다.

  1. 기존 프로젝트의 실제 가동률과 cash flow는 얼마나 빨리 정상화되는가?
  2. Plaquemines의 ramp-up이 계획대로 진행되는가?
  3. CP2가 permit·financing·construction risk를 줄여가고 있는가?
  4. Henry Hub와 국제 LNG 가격의 spread는 충분한가?
  5. contracted volume과 flexible cargo의 조합은 어떤가?
  6. 성장에 필요한 debt와 financing cost를 감당할 수 있는가?
  7. 시장이 아직 반영하지 않은 earnings capacity가 실제로 존재하는가?

VG는 단순 commodity bet보다는 대규모 LNG 프로젝트가 단계적으로 현금흐름 자산으로 변환되는 execution story로 보는 편이 더 정확하다.

바로 열어볼 공식 보고서


공식 자료와 더 읽기

처음 읽는 분을 위한 시작 글

검색 결과가 없거나 어디서부터 읽을지 모르겠다면, 아래 세 글에서 시작해 보세요. 각 글은 용어를 먼저 풀고 원문과 공식 자료 링크를 함께 제공합니다.