확산 LLM은 왜 아무 순서로 쓰면 추론을 놓칠까?
한 문장으로 먼저
AI가 문장을 더 자유롭게 채울 수 있다고 해서 수학·코드 문제를 항상 더 잘 푸는 것은 아닙니다. JustGRPO는 확산 언어 모델을 보상으로 훈련할 때만 답을 왼쪽에서 오른쪽으로 쓰게 했고, 저자들의 공개 실험에서는 그 편이 더 다양한 정답 경로를 남겼다고 보고했습니다.
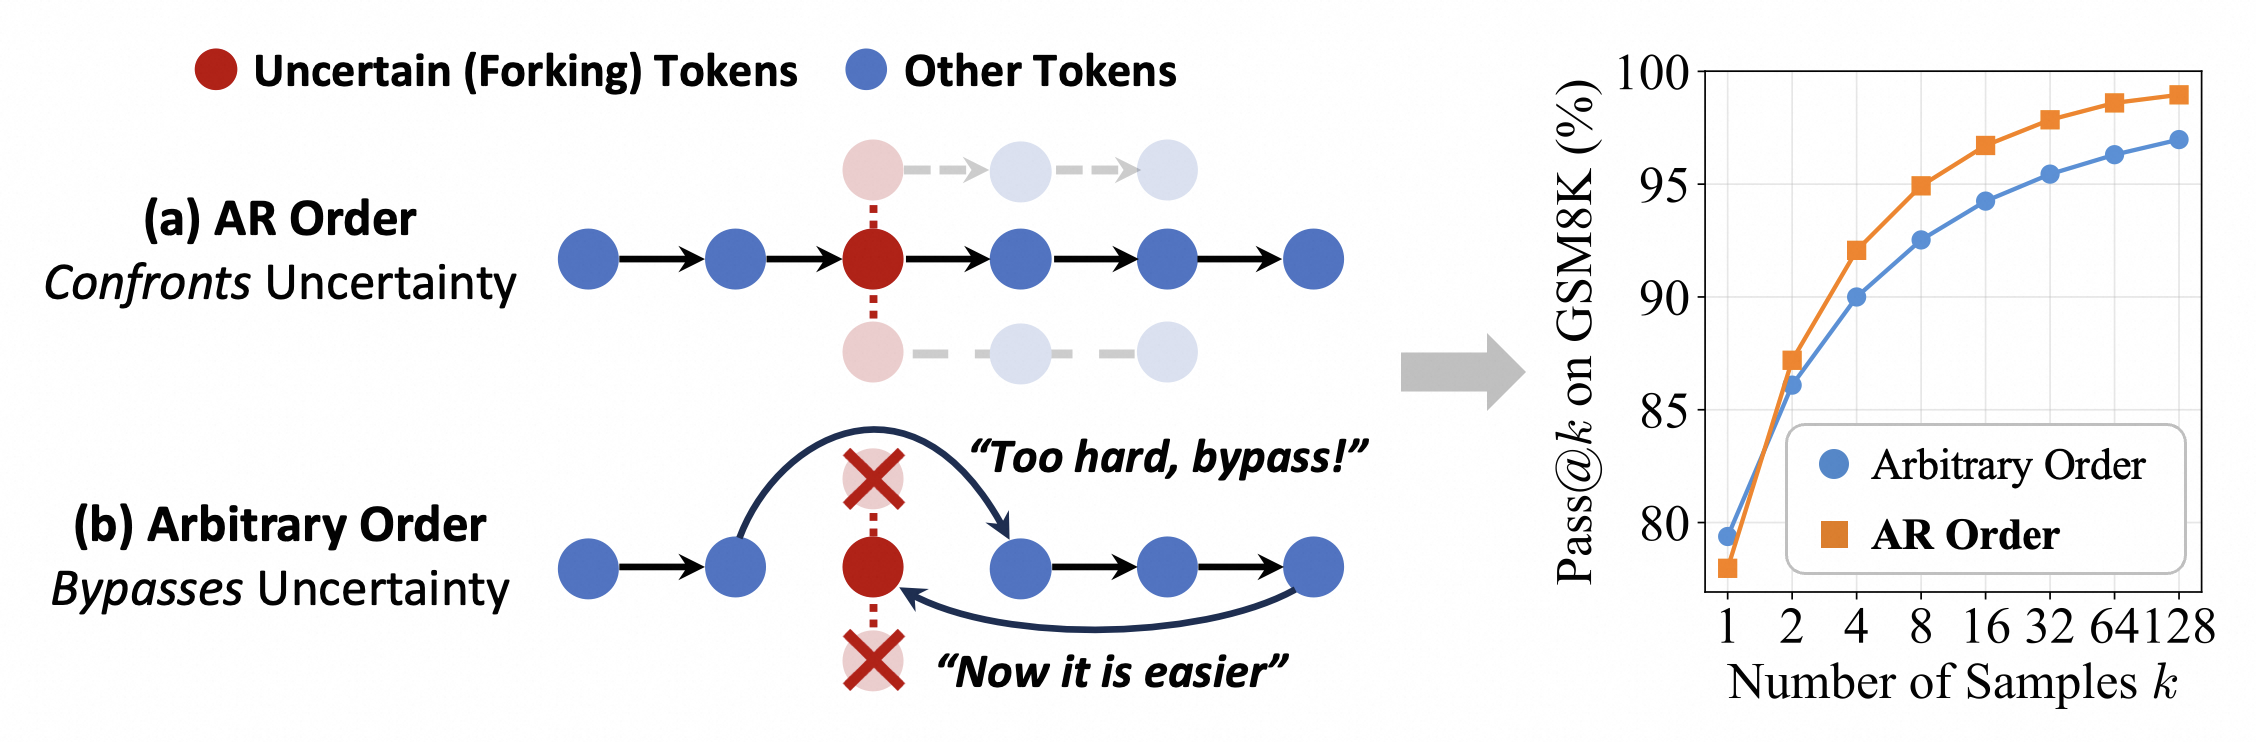
보통 ChatGPT 같은 언어 모델은 앞에서 쓴 말 다음에 올 말을 고르며 문장을 만듭니다. 이를 왼쪽에서 오른쪽으로 한 칸씩 쓰는 방식이라고 생각하면 됩니다. 반면 확산 언어 모델은 문장 전체의 빈칸을 보고, 자신 있는 위치부터 먼저 채울 수 있습니다. 지우개로 일부가 가려진 문장에서 쉬운 단어부터 복원하는 느낌에 가깝습니다.
겉으로는 빈칸을 마음대로 채우는 쪽이 더 똑똑해 보입니다. 하지만 수학 풀이와 코드 작성에서는 그러므로, 따라서, 조건 분기처럼 앞뒤 논리를 이어 주는 짧은 부분이 중요합니다. 연구진은 모델이 확신 높은 숫자나 흔한 표현을 먼저 채우면, 이런 어려운 연결 지점을 나중에 억지로 맞춰 넣게 될 수 있다고 설명합니다. 이미 답의 뼈대가 정해진 뒤에 논리를 끼워 넣는 셈입니다.
여기서 나오는 Pass@k는 답을 k번 만들었을 때 하나라도 맞는 답이 있을 가능성을 보는 지표입니다. 같은 문제를 네 번 풀어도 비슷한 오답만 반복하면 기회가 늘지 않습니다. 반대로 서로 다른 방법을 시도하면 하나가 맞을 수 있습니다. JustGRPO가 말하는 핵심은 ‘더 많은 답을 만들자’가 아니라, 답이 너무 이른 시점에 한 방향으로 굳지 않게 하자에 가깝습니다.
JustGRPO는 정확히 무엇을 바꿨나
이름이 복잡하지만 핵심 변경은 작습니다. 같은 문제에 답안 여러 개를 만들고, 수학 답이 맞는지 또는 코드가 테스트를 통과하는지 확인합니다. 더 좋은 답에 더 높은 점수를 주고 다음 학습에서 그 선택을 더 자주 하도록 조정합니다. 이를 보상 학습이라고 합니다.
JustGRPO는 이 학습 과정에서만 답을 한 줄씩 차례로 만들게 합니다. 사용자가 답을 받을 때 확산 모델의 병렬 복원 방식을 완전히 없앤 것은 아닙니다. 따라서 “확산 LLM을 보통 언어 모델로 바꿨다”는 설명보다 “보상 학습 때의 답안 생성 순서를 단순하게 정했다”가 정확합니다.
저자 공개 저장소의 길이 256 설정에서 수학·코드 네 과제의 결과는 GSM8K 89.1, MATH-500 45.1, HumanEval 49.4, MBPP 52.4였습니다. 숫자는 서로 다른 시험의 점수라서 89.1이 49.4보다 두 배 낫다는 뜻은 아닙니다. 중요한 것은 동일 연구의 설정 안에서, 임의 순서의 장점을 무조건 살리는 대신 학습 경로를 단순화했을 때 강한 결과가 나왔다는 점입니다.
여기까지는 알 수 있고, 여기부터는 아직 모른다
ICML 2026 Outstanding Paper 수상과 공개 코드·체크포인트는 이 연구를 살펴볼 좋은 이유입니다. 다만 이 결과가 모든 대화, 창작, 과학 연구, 실제 서비스에 그대로 적용된다는 뜻은 아닙니다. 이 연구는 수학과 코드 벤치마크를 중심으로 했고, 여러 답 중 하나를 고를 수 있는 Pass@k도 실제 사용자가 한 번 받는 답의 안전성이나 유용성과는 다릅니다.
또한 이 AI가 자기 목적을 정해 스스로 진화한 것은 아닙니다. 사람이 문제와 채점 규칙, 학습 조건을 정했고 모델은 그 안에서 더 높은 보상을 받은 선택을 배우는 것입니다. 다음 AI 뉴스를 볼 때는 무엇을 바꿨는지, 한 번의 정답률인지 여러 번 시도의 지표인지, 같은 비용과 조건에서 비교했는지, 코드와 평가 규칙이 공개됐는지를 확인하면 좋습니다.
수식과 원본 결과 그림, AR·확산 생성의 차이를 더 자세히 보고 싶다면 GitHub Pages 전체 해설을 이어서 읽을 수 있습니다.
공식 자료
첫 그림은 LeapLab·Tsinghua University가 JustGRPO 저장소에 MIT 라이선스로 공개한 원본 PNG이고 변경하지 않았습니다. 두 번째 그림은 JJo가 학습과 추론의 차이를 설명하기 위해 직접 만든 도식이며, 실제 성능·비용 비율을 나타내지 않습니다.


0개의 덧글
댓글 쓰기
에 가입 댓글 [Atom]
← 홈